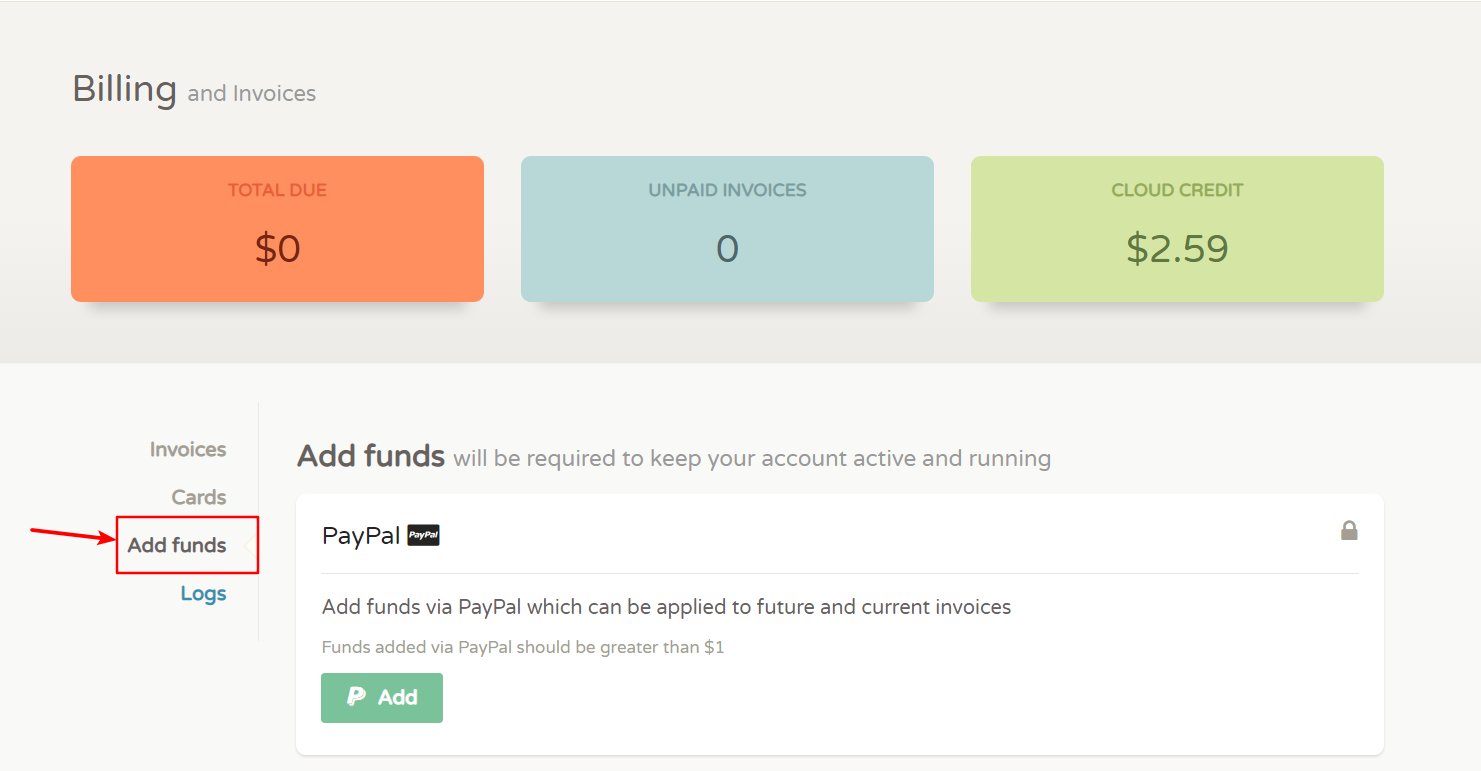
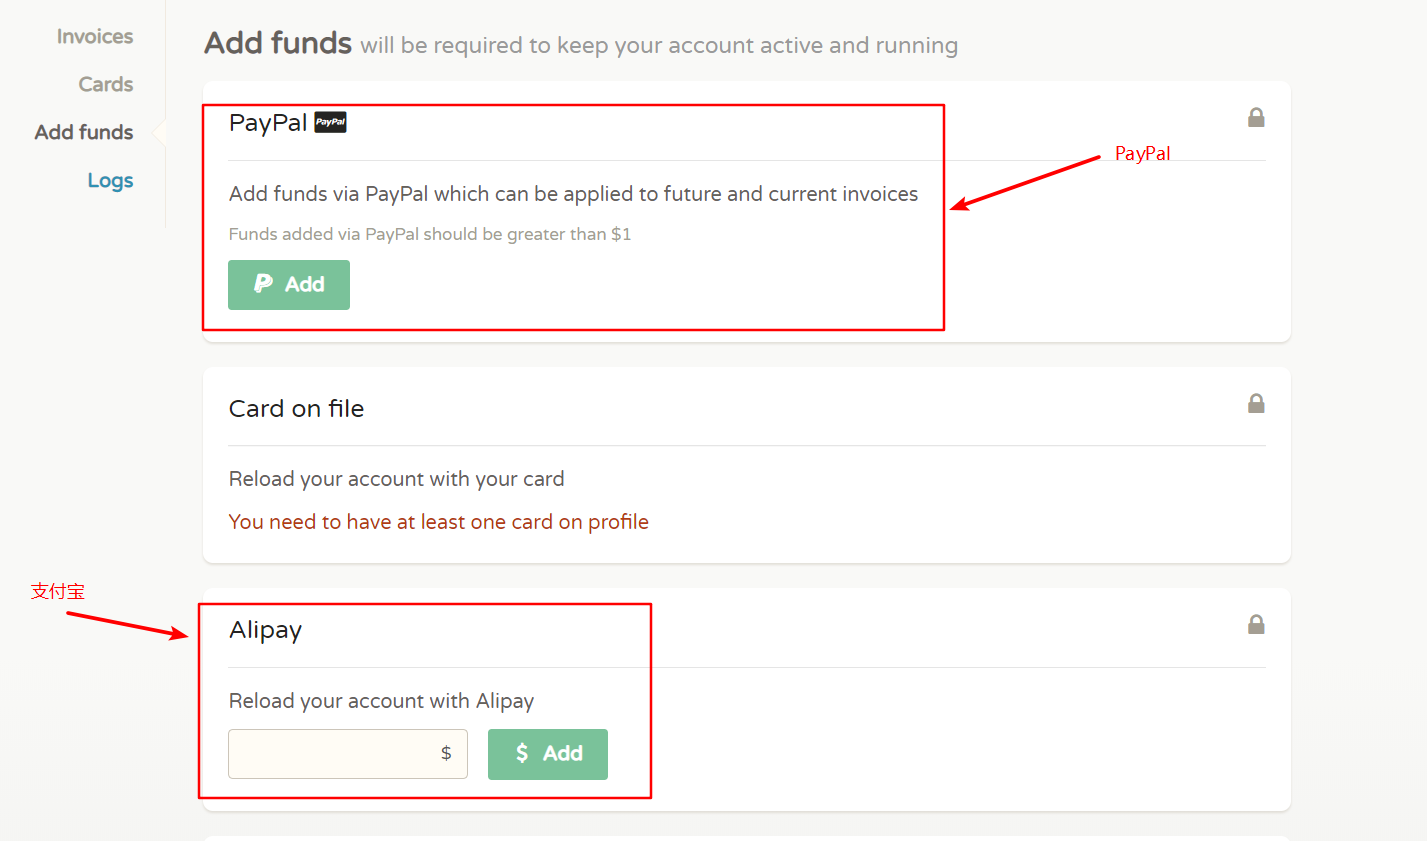
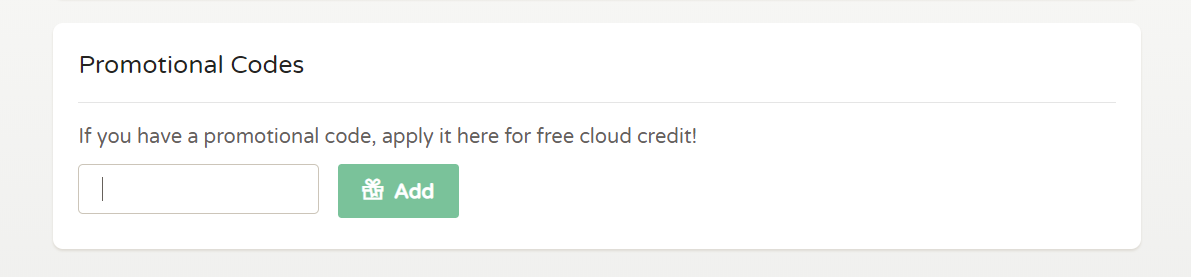
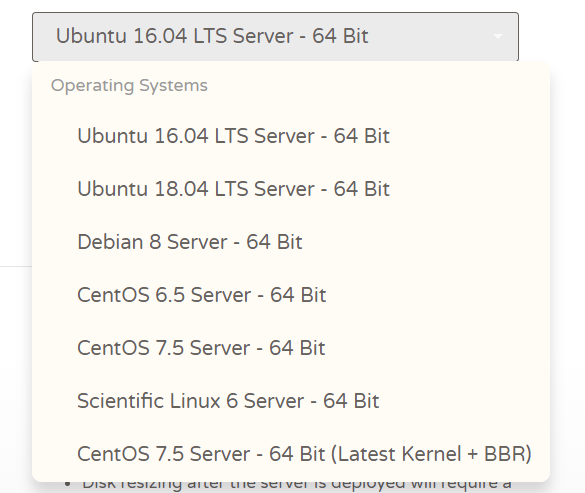
<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
    <id>https://Littlecowherd.github.io</id>
    <title>有间小酒馆</title>
    <updated>2020-08-25T09:50:41.459Z</updated>
    <generator>https://github.com/jpmonette/feed</generator>
    <link rel="alternate" href="https://Littlecowherd.github.io"/>
    <link rel="self" href="https://Littlecowherd.github.io/atom.xml"/>
    <subtitle>从前有个人的小酒馆</subtitle>
    <logo>https://Littlecowherd.github.io/images/avatar.png</logo>
    <icon>https://Littlecowherd.github.io/favicon.ico</icon>
    <rights>All rights reserved 2020, 有间小酒馆</rights>
    <entry>
        <title type="html"><![CDATA[Python 常见数据结构的底层实现]]></title>
        <id>https://Littlecowherd.github.io/post/hQGohA5NG/</id>
        <link href="https://Littlecowherd.github.io/post/hQGohA5NG/">
        </link>
        <updated>2020-08-20T06:46:48.000Z</updated>
        <content type="html"><![CDATA[<h3 id="字典的内部实现">字典的内部实现</h3>
<p><code>PyDictObject</code>对象就是dict的内部实现，CPython 采用<strong>哈希表</strong>来实现 dict（与之不同的是，C++ 采用红黑树来实现 map）。</p>
<h4 id="哈希表-hash-tables">哈希表 (HASH TABLES)</h4>
<p>哈希表（也叫散列表），根据关键值对(Key-value)而直接进行访问的数据结构。它通过把key和value映射到表中一个位置来访问记录，这种查询速度非常快，更新也快。而这个映射函数叫做哈希函数，存放值的数组叫做哈希表。 哈希函数的实现方式决定了哈希表的搜索效率。具体操作过程是：</p>
<ol>
<li>数据添加：把key通过哈希函数转换成一个整型数字，然后就将该数字对数组长度进行取余，取余结果就当作数组的下标，将value存储在以该数字为下标的数组空间里。</li>
<li>数据查询：再次使用哈希函数将key转换为对应的数组下标，并定位到数组的位置获取value。</li>
</ol>
<p>但是，对key进行hash的时候，不同的key可能hash出来的结果是一样的，尤其是数据量增多的时候，这个问题叫做哈希冲突。</p>
<p>如果解决这种冲突情况呢？通常的做法有两种，一种是<strong>链地址法</strong>，另一种是<strong>开放寻址法</strong>，Python选择后者。因为<strong>链地址法会带来分配链表的开销</strong>，而 CPython 中 dict 又运用得极其普遍，因此 dict 采用开放寻址法来实现哈希表</p>
<h4 id="开放寻址法open-addressing">开放寻址法（OPEN ADDRESSING）</h4>
<p>开放寻址法中，所有的元素都存放在散列表里，当产生哈希冲突时，通过一个探测函数计算出下一个候选位置，如果下一个候选位置还是有冲突，那么不断通过探测函数往下找，直到找个一个空槽来存放待插入元素。</p>
<p>值得注意的是，当哈希函数选择不当时，哈希值可能堆积在一起从而产生一次聚集或二次聚集的现象。这会使落在这个聚集区间内的哈希值总要探查多次才能找到正确的位置，从而极大的降低哈希的效率，特别是对于开放寻址法来说。可见，哈希函数的选择对哈希表至关重要。</p>
<h4 id="pydictentry">PYDICTENTRY</h4>
<p>字典中的一个key-value键值对元素称为 entry（也叫做 slots），对应到 Python 内部是 <code>PyDictEntry</code>，<code>PyDictObject</code> 就是 <code>PyDictEntry</code> 的集合。<code>PyDictEntry</code> 的定义是：</p>
<pre><code class="language-c">typedef struct {
    /* Cached hash code of me_key.  Note that hash codes are C longs.
     * We have to use Py_ssize_t instead because dict_popitem() abuses
     * me_hash to hold a search finger.
     */
    Py_ssize_t me_hash;
    PyObject *me_key;
    PyObject *me_value;
} PyDictEntry;
</code></pre>
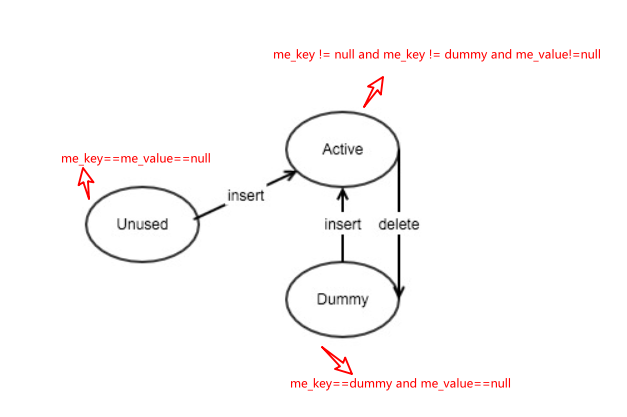
<p>me_hash用于缓存me_key的哈希值，防止每次查询时都要计算哈希值，entry有三种状态。</p>
<ol>
<li>
<p>Unused： me_key == me_value == NULL</p>
<p>Unused是entry的初始状态，key和value都为NULL。这是me_key为NULL的唯一情况。 插入元素时，Unused状态转换成Active状态。</p>
</li>
<li>
<p>Active: me_key != NULL and me_key != dummy and me_value != NULL</p>
<p>插入元素后，entry就成了Active状态，这是me_value唯一不为NULL的情况，删除元素时Active状态刻转换成Dummy状态。</p>
</li>
<li>
<p>Dummy: me_key == dummy and me_value == NULL</p>
<p>此处的dummy对象实际上一个<code>PyStringObject</code>对象，仅作为指示标志。Dummy状态的元素可以在插入元素的时候将它变成Active状态，但它不可能再变成Unused状态。</p>
</li>
</ol>
<figure data-type="image" tabindex="1"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200820150305.png" alt="image-20200819215942008" loading="lazy"></figure>
<p>为啥要有 Dummy 状态呢？</p>
<p><strong>首先明确 Dummy 是一种类似伪删除的方式，保证了探测链的连续性。</strong> 下面详细解释：</p>
<p>在开放寻址法中，遇到hash冲突时会通过探测函数找到下一个合适的位置。</p>
<p>例如，某元素通过 hash 计算应该插入 A，但A处已经有元素，则继续根据探测函数找到 B，B处也有元素，直到	找到位置C 为止。此时 ABC 构成了探测链。 查找时，如果元素的hash值相同，那么也是顺着这个链不断往下找，当删除探测链中的某个元素时，比如删除 B ，如果直接把 B 从hash表中删除，变成 Unused 状态，那么 C 就找不到了，因为AC之间出现了断裂的现象。</p>
<h4 id="pydictobject">PYDICTOBJECT</h4>
<p><code>PyDictObject</code>就是<code>PyDictEntry</code>对象的集合，<code>PyDictObject</code>的结构是：</p>
<pre><code class="language-c">typedef struct _dictobject PyDictObject;
struct _dictobject {
    PyObject_HEAD
    Py_ssize_t ma_fill;  /* # Active + # Dummy */
    Py_ssize_t ma_used;  /* # Active */

    /* The table contains ma_mask + 1 slots, and that's a power of 2.
     * We store the mask instead of the size because the mask is more
     * frequently needed.
     */
    Py_ssize_t ma_mask;

    /* ma_table points to ma_smalltable for small tables, else to
     * additional malloc'ed memory.  ma_table is never NULL!  This rule
     * saves repeated runtime null-tests in the workhorse getitem and
     * setitem calls.
     */
    PyDictEntry *ma_table;
    PyDictEntry *(*ma_lookup)(PyDictObject *mp, PyObject *key, long hash);
    PyDictEntry ma_smalltable[PyDict_MINSIZE];
};
</code></pre>
<ul>
<li>
<p>ma_fill ：所有处于Active以及Dummy的元素个数</p>
</li>
<li>
<p>ma_used ：所有处于Active状态的元素个数</p>
</li>
<li>
<p>ma_mask ：所有entry的元素个数（Active+Dummy+Unused）</p>
</li>
<li>
<p>ma_smalltable：创建字典对象时，一定会创建一个大小为<code>PyDict_MINSIZE==8</code>的<code>PyDictEntry</code>数组。</p>
</li>
<li>
<p>ma_table：当entry数量小于<code>PyDict_MINSIZE</code>，ma_table指向ma_smalltable的首地址，当entry数量大于8时，Python把它当做一个大字典来处理，此刻会申请额外的内存空间，同时将ma_table指向这块空间。</p>
</li>
<li>
<p>ma_lookup：字典元素的搜索策略</p>
<p><code>PyDictObject</code>使用<code>PyObject_HEAD</code>而不是<code>PyObject_Var_HEAD</code>，虽然字典也是变长对象，但此处并不是通过ob_size来存储字典中元素的长度，而是通过ma_used字段。</p>
</li>
</ul>
<blockquote>
<p>衡量哈希表的冲突率的一个指标是哈希表的<strong>负载因子</strong>，它等于哈希表已使用的空间除以哈希表的总空间。直观上来说，它反映了哈希表中的一个位置平均储存的数据个数。当负载因子的值大于 2/3 时，哈希发生冲突的概率就将大大增加。因此，当 dict 中的哈希表负载因子大于 2/3 时，解释器会重新分配哈希表的大小使其负载因子小于 2/3。</p>
</blockquote>
<h4 id="pydictobject的创建过程">PYDICTOBJECT的创建过程</h4>
<pre><code class="language-c">PyObject *
PyDict_New(void)
{
    register PyDictObject *mp;
    if (dummy == NULL) { /* Auto-initialize dummy */
        dummy = PyString_FromString(&quot;&lt;dummy key&gt;&quot;);
        if (dummy == NULL)
            return NULL;
    }
    if (numfree) {
        mp = free_list[--numfree];
        assert (mp != NULL);
        assert (Py_TYPE(mp) == &amp;PyDict_Type);
        _Py_NewReference((PyObject *)mp);
        if (mp-&gt;ma_fill) {
            EMPTY_TO_MINSIZE(mp);
        } else {
            /* At least set ma_table and ma_mask; these are wrong
               if an empty but presized dict is added to freelist */
            INIT_NONZERO_DICT_SLOTS(mp);
        }
        assert (mp-&gt;ma_used == 0);
        assert (mp-&gt;ma_table == mp-&gt;ma_smalltable);
        assert (mp-&gt;ma_mask == PyDict_MINSIZE - 1);
    } else {
        mp = PyObject_GC_New(PyDictObject, &amp;PyDict_Type);
        if (mp == NULL)
            return NULL;
        EMPTY_TO_MINSIZE(mp);
    }
    mp-&gt;ma_lookup = lookdict_string;
    return (PyObject *)mp;
}
</code></pre>
<ol>
<li>初始化dummy对象</li>
<li>如果缓冲池还有可用的对象，则从缓冲池中读取，否则，执行步骤3</li>
<li>分配内存空间，创建<code>PyDictObject</code>对象，初始化对象</li>
<li>指定添加字典元素时的探测函数，元素的搜索策略</li>
</ol>
<h4 id="字典搜索策略">字典搜索策略</h4>
<pre><code class="language-c">static PyDictEntry *
lookdict(PyDictObject *mp, PyObject *key, register long hash)
{
    register size_t i;
    register size_t perturb;
    register PyDictEntry *freeslot;
    register size_t mask = (size_t)mp-&gt;ma_mask;
    PyDictEntry *ep0 = mp-&gt;ma_table;
    register PyDictEntry *ep;
    register int cmp;
    PyObject *startkey;

    i = (size_t)hash &amp; mask;
    ep = &amp;ep0[i];
    if (ep-&gt;me_key == NULL || ep-&gt;me_key == key)
        return ep;

    if (ep-&gt;me_key == dummy)
        freeslot = ep;
    else {
        if (ep-&gt;me_hash == hash) {
            startkey = ep-&gt;me_key;
            Py_INCREF(startkey);
            cmp = PyObject_RichCompareBool(startkey, key, Py_EQ);
            Py_DECREF(startkey);
            if (cmp &lt; 0)
                return NULL;
            if (ep0 == mp-&gt;ma_table &amp;&amp; ep-&gt;me_key == startkey) {
                if (cmp &gt; 0)
                    return ep;
            }
            else {
                /* The compare did major nasty stuff to the
                 * dict:  start over.
                 * XXX A clever adversary could prevent this
                 * XXX from terminating.
                 */
                return lookdict(mp, key, hash);
            }
        }
        freeslot = NULL;
    }

    /* In the loop, me_key == dummy is by far (factor of 100s) the
       least likely outcome, so test for that last. */
    for (perturb = hash; ; perturb &gt;&gt;= PERTURB_SHIFT) {
        i = (i &lt;&lt; 2) + i + perturb + 1;
        ep = &amp;ep0[i &amp; mask];
        if (ep-&gt;me_key == NULL)
            return freeslot == NULL ? ep : freeslot;
        if (ep-&gt;me_key == key)
            return ep;
        if (ep-&gt;me_hash == hash &amp;&amp; ep-&gt;me_key != dummy) {
            startkey = ep-&gt;me_key;
            Py_INCREF(startkey);
            cmp = PyObject_RichCompareBool(startkey, key, Py_EQ);
            Py_DECREF(startkey);
            if (cmp &lt; 0)
                return NULL;
            if (ep0 == mp-&gt;ma_table &amp;&amp; ep-&gt;me_key == startkey) {
                if (cmp &gt; 0)
                    return ep;
            }
            else {
                /* The compare did major nasty stuff to the
                 * dict:  start over.
                 * XXX A clever adversary could prevent this
                 * XXX from terminating.
                 */
                return lookdict(mp, key, hash);
            }
        }
        else if (ep-&gt;me_key == dummy &amp;&amp; freeslot == NULL)
            freeslot = ep;
    }
    assert(0);          /* NOT REACHED */
    return 0;
}
</code></pre>
<p>字典在添加元素和查询元素时，都需要用到字典的搜索策略。</p>
<p>搜索时，如果不存在该key，那么返回Unused状态的entry，如果存在该key，但是key是一个Dummy对象，那么返回Dummy状态的entry，其他情况就表示存在Active状态的entry，那么对于字典的插入操作，针对不同的情况进行操作也不一样。对于Active的entry，直接替换me_value值即可；对于Unused或Dummy的entry，需要同时设置me_key，me_hash和me_value</p>
<h4 id="pydictobject对象缓冲池">PYDICTOBJECT对象缓冲池</h4>
<p><code>PyDictObject</code>对象缓冲池和<code>PyListObject</code>对象缓冲池的原理是类似的，都是在对象被销毁的时候把该对象添加到缓冲池中去，而且只保留<code>PyDictObject</code>对象本身，如果ma_table维护的是从系统堆中申请的空间，那么Python会释放这块内存，如果ma_table维护的是ma_smalltable，那么只需把smalltable中的元素的引用计数减少即可。</p>
<pre><code class="language-c">static void
dict_dealloc(register PyDictObject *mp)
{
    register PyDictEntry *ep;
    Py_ssize_t fill = mp-&gt;ma_fill;
    PyObject_GC_UnTrack(mp);
    Py_TRASHCAN_SAFE_BEGIN(mp)
    for (ep = mp-&gt;ma_table; fill &gt; 0; ep++) {
        if (ep-&gt;me_key) {
            --fill;
            Py_DECREF(ep-&gt;me_key);
            Py_XDECREF(ep-&gt;me_value);
        }
    }
    if (mp-&gt;ma_table != mp-&gt;ma_smalltable)
        PyMem_DEL(mp-&gt;ma_table);
    if (numfree &lt; PyDict_MAXFREELIST &amp;&amp; Py_TYPE(mp) == &amp;PyDict_Type)
        free_list[numfree++] = mp;
    else
        Py_TYPE(mp)-&gt;tp_free((PyObject *)mp);
    Py_TRASHCAN_SAFE_END(mp)
}
</code></pre>
<p>为了避免频繁申请、释放内存，导致过多的系统调用，在 CPython 中，很多内建对象都有自己的缓存池。例如，整数有针对小整数的缓存池([-5, 256])，字符串有针对短字符串的缓存池，同样，dict 也有自己的缓存池.</p>
<h3 id="列表的内部实现">列表的内部实现</h3>
<p>Python中的列表基于<code>PyListObject</code>实现，列表支持元素的插入、删除、更新操作，因此<code>PyListObject</code>是一个变长对象（<strong>列表的长度随着元素的增加和删除而变长和变短</strong>），同时它还是一个可变对象（列表中的元素根据列表的操作而发生变化，内存大小动态的变化）</p>
<p>PyListObject的定义：</p>
<pre><code class="language-c">typedef struct {
    # 列表对象引用计数
    int ob_refcnt;  
    # 列表类型对象      
    struct _typeobject *ob_type;
    # 列表元素的长度
    int ob_size; /* Number of items in variable part */
    # 真正存放列表元素容器的指针，list[0] 就是 ob_item[0]
    PyObject **ob_item;
    # 当前列表可容纳的元素大小
    Py_ssize_t allocated;
} PyListObject;
</code></pre>
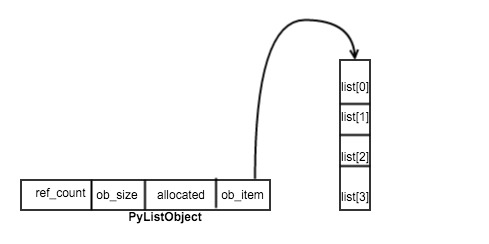
<p>咋一看PyListObject对象的定义非常简单，除了通用对象都有的引用计数（<code>ob_refcnt</code>）、类型信息（ob_type），以及变长对象的长度（ob_size）之外，剩下的只有ob_item，和 allocated，ob_item是真正存放列表元素容器的指针，专门有一块内存用来存储列表元素，这块内存的大小就是allocated所能容纳的空间。allocated是列表所能容纳的元素大小，而且满足条件：</p>
<ul>
<li><strong>0 &lt;= ob_size &lt;= allocated</strong></li>
<li><strong>len(list) == ob_size</strong></li>
<li><strong>ob_item == NULL 时 ob_size == allocated == 0</strong></li>
</ul>
<figure data-type="image" tabindex="2"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200820150004.jpg" alt="pylistobject" loading="lazy"></figure>
<h4 id="列表对象的创建">列表对象的创建</h4>
<p><code>PylistObject</code>对象的是通过函数<code>PyList_New</code>创建而成，接收参数<strong>size</strong>，该参数用于指定列表对象所能容纳的最大元素个数。</p>
<pre><code class="language-c">// 列表缓冲池, PyList_MAXFREELIST为80
static PyListObject *free_list[PyList_MAXFREELIST];
//缓冲池当前大小
static int numfree = 0;

PyObject *PyList_New(Py_ssize_t size)
{
    PyListObject *op; //列表对象
    size_t nbytes;    //创建列表对象需要分配的内存大小

    if (size &lt; 0) {
        PyErr_BadInternalCall();
        return NULL;
    }
    /* Check for overflow without an actual overflow,
     *  which can cause compiler to optimise out */
    if ((size_t)size &gt; PY_SIZE_MAX / sizeof(PyObject *))
        return PyErr_NoMemory();
    nbytes = size * sizeof(PyObject *);
    if (numfree) {
        numfree--;
        op = free_list[numfree];
        _Py_NewReference((PyObject *)op);

    } else {
        op = PyObject_GC_New(PyListObject, &amp;PyList_Type);
        if (op == NULL)
            return NULL;

    }
    if (size &lt;= 0)
        op-&gt;ob_item = NULL;
    else {
        op-&gt;ob_item = (PyObject **) PyMem_MALLOC(nbytes);
        if (op-&gt;ob_item == NULL) {
            Py_DECREF(op);
            return PyErr_NoMemory();
        }
        memset(op-&gt;ob_item, 0, nbytes);
    }
    # 设置ob_size
    Py_SIZE(op) = size;
    op-&gt;allocated = size;
    _PyObject_GC_TRACK(op);
    return (PyObject *) op;
}
</code></pre>
<p><strong>创建过程</strong>大致是：</p>
<ol>
<li>检查size参数是否有效，如果小于0，直接返回NULL，创建失败</li>
<li>检查size参数是否超出Python所能接受的大小，如果大于PY_SIZE_MAX（64位机器为8字节，在32位机器为4字节），内存溢出。</li>
<li>检查缓冲池free_list是否有可用的对象，有则直接从缓冲池中使用，没有则创建新的PyListObject，分配内存。</li>
<li>初始化ob_item中的元素的值为Null</li>
<li>设置PyListObject的allocated和ob_size。</li>
</ol>
<h4 id="pylistobject对象的缓冲池">PYLISTOBJECT对象的缓冲池</h4>
<p><code>free_list</code>是<code>PyListObject</code>对象的缓冲池，<strong>其大小为80</strong>，那么PyListObject对象是什么时候加入到缓冲池free_list的呢？答案在<code>list_dealloc</code>方法中：</p>
<pre><code class="language-c">static void
list_dealloc(PyListObject *op)
{
    Py_ssize_t i;
    PyObject_GC_UnTrack(op);
    Py_TRASHCAN_SAFE_BEGIN(op)
    if (
        i = Py_SIZE(op);
        while (--i &gt;= 0) {
            Py_XDECREF(op-&gt;ob_item[i]);
        }
        PyMem_FREE(op-&gt;ob_item);
    }
    if (numfree &lt; PyList_MAXFREELIST &amp;&amp; PyList_CheckExact(op))
        free_list[numfree++] = op;
    else
        Py_TYPE(op)-&gt;tp_free((PyObject *)op);
    Py_TRASHCAN_SAFE_END(op)
}
</code></pre>
<p>当PyListObject对象被销毁的时候，首先将列表中所有元素的引用计数减一，然后释放ob_item占用的内存，只要缓冲池空间还没满，那么就把该PyListObject加入到缓冲池中（此时PyListObject占用的内存并不会正真正回收给系统，下次创建PyListObject优先从缓冲池中获取PyListObject），否则释放PyListObject对象的内存空间。</p>
<h4 id="列表元素插入">列表元素插入</h4>
<p>设置列表某个位置的值时，如“list[1]=0”，列表的内存结构并不会发生变化，而往列表中插入元素时会改变列表的内存结构：</p>
<pre><code class="language-c">static int
ins1(PyListObject *self, Py_ssize_t where, PyObject *v)
{
    // n是列表元素长度
    Py_ssize_t i, n = Py_SIZE(self);
    PyObject **items;
    if (v == NULL) {
        PyErr_BadInternalCall();
        return -1;
    }
    if (n == PY_SSIZE_T_MAX) {
        PyErr_SetString(PyExc_OverflowError,
            &quot;cannot add more objects to list&quot;);
        return -1;
    }

    if (list_resize(self, n+1) == -1)
        return -1;

    if (where &lt; 0) {
        where += n;
        if (where &lt; 0)
            where = 0;
    }
    if (where &gt; n)
        where = n;
    items = self-&gt;ob_item;
    for (i = n; --i &gt;= where; )
        items[i+1] = items[i];
    Py_INCREF(v);
    items[where] = v;
    return 0;
}
</code></pre>
<p>相比设置某个列表位置的值来说，<strong>插入操作要多一次PyListObject容量大小的调整，逻辑是list_resize</strong>，其次是挪动where之后的元素位置。</p>
<pre><code class="language-c">// newsize： 列表新的长度
static int  
list_resize(PyListObject *self, Py_ssize_t newsize)
{
    PyObject **items;
    size_t new_allocated;
    Py_ssize_t allocated = self-&gt;allocated;


    if (allocated &gt;= newsize &amp;&amp; newsize &gt;= (allocated &gt;&gt; 1)) {
        assert(self-&gt;ob_item != NULL || newsize == 0);
        Py_SIZE(self) = newsize;
        return 0;
    }

    new_allocated = (newsize &gt;&gt; 3) + (newsize &lt; 9 ? 3 : 6);

    /* check for integer overflow */
    if (new_allocated &gt; PY_SIZE_MAX - newsize) {
        PyErr_NoMemory();
        return -1;
    } else {
        new_allocated += newsize;
    }

    if (newsize == 0)
        new_allocated = 0;
    items = self-&gt;ob_item;
    if (new_allocated &lt;= (PY_SIZE_MAX / sizeof(PyObject *)))
        PyMem_RESIZE(items, PyObject *, new_allocated);
    else
        items = NULL;
    if (items == NULL) {
        PyErr_NoMemory();
        return -1;
    }
    self-&gt;ob_item = items;
    Py_SIZE(self) = newsize;
    self-&gt;allocated = new_allocated;
    return 0;
}
</code></pre>
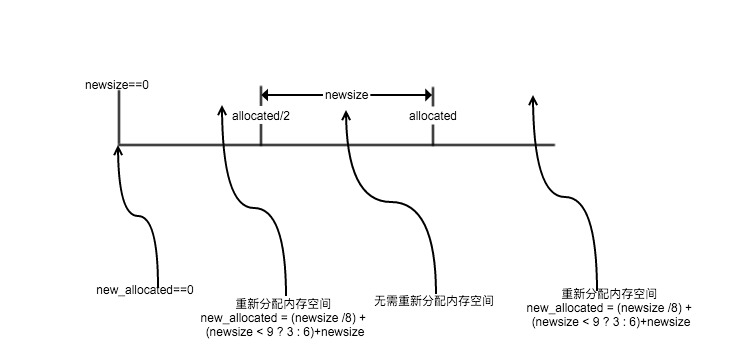
<p>满足 <code>allocated &gt;= newsize &amp;&amp; newsize &gt;= (allocated /2)</code>时，简单改变list的元素长度，PyListObject对象不会重新分配内存空间，否则重新分配内存空间，如果<code>newsize&lt;allocated/2</code>，那么会减缩内存空间，如果<code>newsize&gt;allocated</code>，就会扩大内存空间。当<code>newsize==0</code>时内存空间将缩减为0。</p>
<figure data-type="image" tabindex="3"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200820150338.jpg" alt="!python_list_resize" loading="lazy"></figure>
<pre><code class="language-python">def list_resize(new_size):
    if new_size == 0:
        new_allocated = 0
    else:
         # 随着size增长，负载因子趋向 8/9
        new_allocated = (new_size &gt;&gt; 3) + (3 if new_size &lt; 9 else 6) + new_size 
    print(new_size, new_allocated, new_size / new_allocated if new_allocated != 0 else None)
</code></pre>
<h4 id="总结">总结</h4>
<ul>
<li>PyListObject缓冲池的创建发生在列表销毁的时候。</li>
<li>PyListObject对象的创建分两步：先创建PyListObject对象，然后初始化元素列表为NULL。</li>
<li>PyListObject对象的销毁分两步：先销毁PyListObject对象中的元素列表，然后销毁PyListObject本身。</li>
<li>PyListObject对象内存的占用空间会根据列表长度的变化而调整。</li>
</ul>
<h2 id="参考资料">参考资料</h2>
<ol>
<li>https://foofish.net/python_dict_implements.html</li>
<li>https://foofish.net/python-list-implements.html</li>
<li>https://arianx.me/2018/12/30/walkthrough-cpython3.7-dict-source-code/</li>
<li>https://www.hongweipeng.com/index.php/series.html</li>
</ol>
]]></content>
    </entry>
    <entry>
        <title type="html"><![CDATA[ 一致性 Hash 算法]]></title>
        <id>https://Littlecowherd.github.io/post/w3NspgHPz/</id>
        <link href="https://Littlecowherd.github.io/post/w3NspgHPz/">
        </link>
        <updated>2020-07-15T09:37:24.000Z</updated>
        <content type="html"><![CDATA[<h1 id="一致性-hash-算法">一致性 Hash 算法</h1>
<p>一致性hash算法提出了在动态变化的Cache环境中，判定哈希算法好坏的<strong>四个定义</strong>：</p>
<p>1、平衡性(Balance)：平衡性是指哈希的结果能够尽可能分布到所有的缓冲中去，这样可以使得所有的缓冲空间都得到利用。很多哈希算法都能够满足这一条件。</p>
<p>2、单调性(Monotonicity)：单调性是指如果已经有一些内容通过哈希分派到了相应的缓冲中，又有新的缓冲加入到系统中。哈希的结果应能够保证原有已分配的内容可以被映射到原有的或者新的缓冲中去，而不会被映射到旧的缓冲集合中的其他缓冲区。</p>
<p>3、分散性(Spread)：在分布式环境中，终端有可能看不到所有的缓冲，而是只能看到其中的一部分。当终端希望通过哈希过程将内容映射到缓冲上时，由于不同终端所见的缓冲范围有可能不同，从而导致哈希的结果不一致，最终的结果是相同的内容被不同的终端映射到不同的缓冲区中。这种情况显然是应该避免的，因为它导致相同内容被存储到不同缓冲中去，降低了系统存储的效率。分散性的定义就是上述情况发生的严重程度。好的哈希算法应能够尽量避免不一致的情况发生，也就是尽量降低分散性。</p>
<p>4、负载(Load)：负载问题实际上是从另一个角度看待分散性问题。既然不同的终端可能将相同的内容映射到不同的缓冲区中，那么对于一个特定的缓冲区而言，也可能被不同的用户映射为不同的内容。与分散性一样，这种情况也是应当避免的，因此好的哈希算法应能够尽量降低缓冲的负荷。</p>
<p>普通的哈希算法（也称硬哈希）采用简单取模的方式，将机器进行散列，这在cache环境不变的情况下能取得让人满意的结果，<strong>但是当cache环境动态变化时，这种静态取模的方式显然就不满足单调性的要求</strong>（当增加或减少一台机子时，几乎所有的存储内容都要被重新散列到别的缓冲区中）。</p>
<p><em>例如原来只有 4 台缓存服务器，缓存的位置将会被映射至 hash%4，如果增加或者减少服务器，或者服务器宕机时， 缓存位置就会发生变化， hash%5 。此时原有的缓存几乎都不可用。</em></p>
<h2 id="一致性hash实现">一致性hash实现</h2>
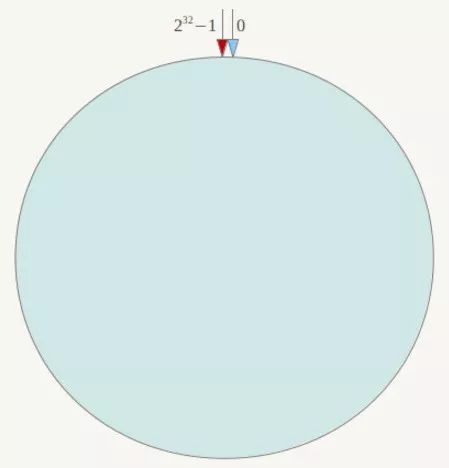
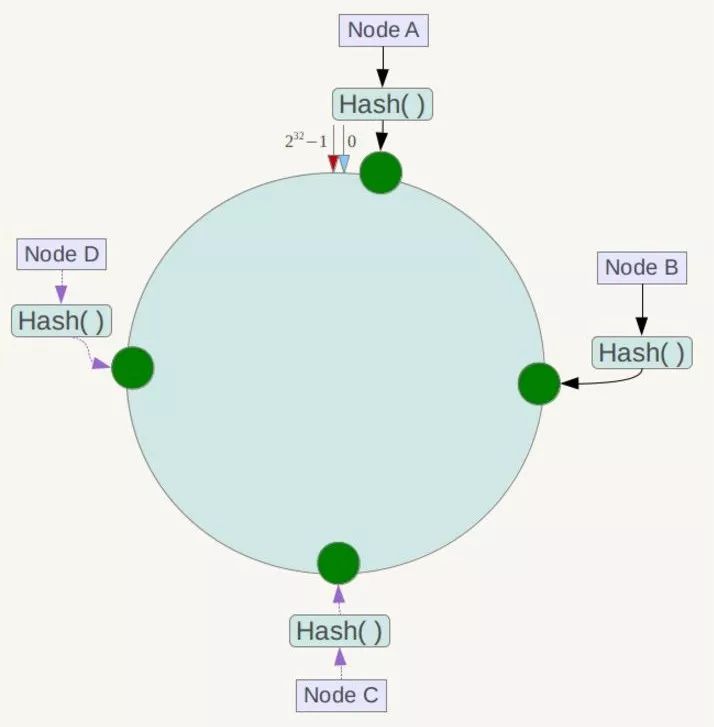
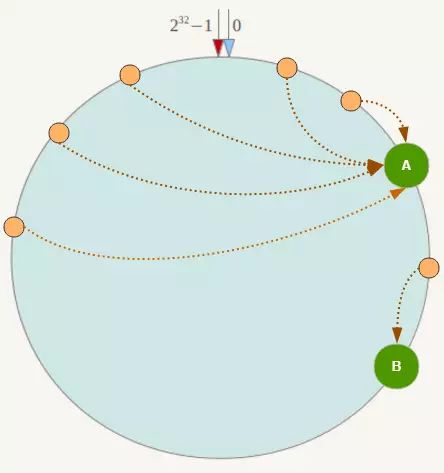
<p>一致性Hash算法也是使用取模的方法，只是，刚才描述的取模法是对服务器的数量进行取模，而**一致性Hash算法是对2<sup>32取模**，什么意思呢？简单来说，一致性Hash算法将整个哈希值空间组织成一个虚拟的圆环，如假设某哈希函数H的值空间为0-2</sup>32-1（即哈希值是一个32位无符号整形），整个哈希环如下：</p>
<figure data-type="image" tabindex="1"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200825173754.jpg" alt="img" loading="lazy"></figure>
<p>整个空间按顺时针方向组织，圆环的正上方的点代表0，0点右侧的第一个点代表1，以此类推，2、3、4、5、6……直到2<sup>32-1，也就是说0点左侧的第一个点代表2</sup>32-1， 0和2<sup>32-1在零点中方向重合，我们把这个由2</sup>32个点组成的圆环称为Hash环。</p>
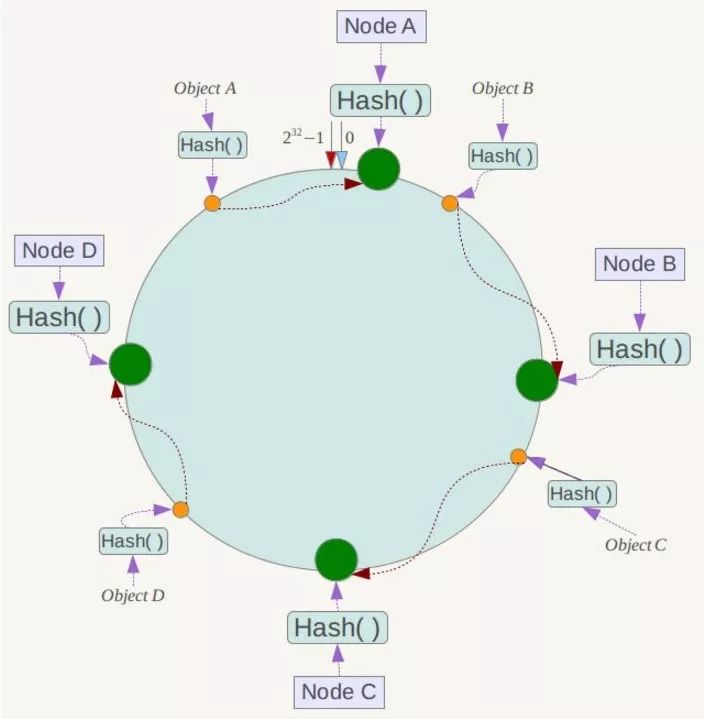
<p>下一步将各个服务器使用Hash进行一个哈希，具体可以选择服务器的IP或主机名作为关键字进行哈希，这样每台机器就能确定其在哈希环上的位置，这里假设将上文中四台服务器使用IP地址哈希后在环空间的位置如下：</p>
<figure data-type="image" tabindex="2"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200825173759.jpg" alt="img" loading="lazy"></figure>
<p>接下来使用如下算法定位数据访问到相应服务器：将数据key使用相同的函数Hash计算出哈希值，并确定此数据在环上的位置，从此位置沿环顺时针“行走”，第一台遇到的服务器就是其应该定位到的服务器！</p>
<p><em>具体如何行走呢？</em></p>
<p><em>是不是可以通过一个字典来保存每个服务器需要缓存的key的范围，通过判断key所属范围来判断其应该行走到哪个key上？</em></p>
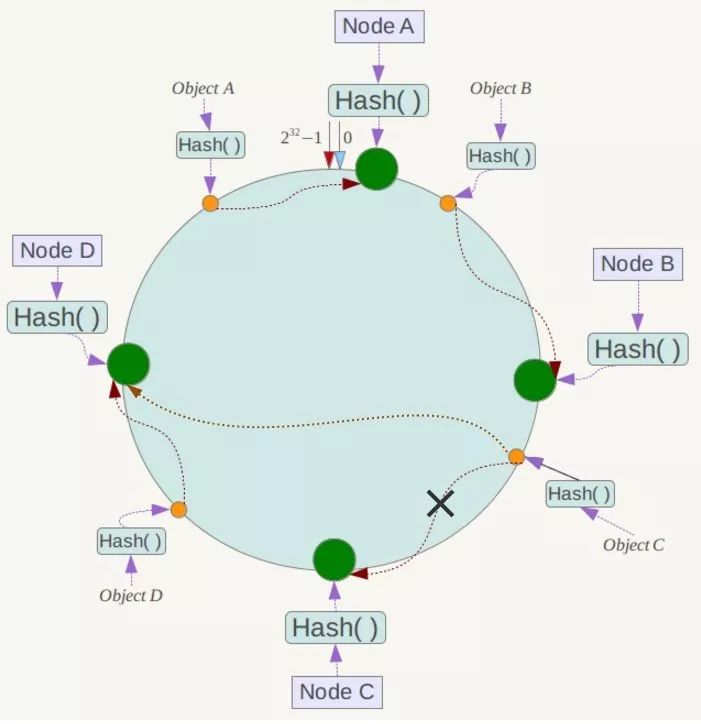
<p>例如我们有Object A、Object B、Object C、Object D四个数据对象，经过哈希计算后，在环空间上的位置如下：</p>
<figure data-type="image" tabindex="3"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200825173805.jpg" alt="img" loading="lazy"></figure>
<p>根据一致性Hash算法，数据A会被定为到Node A上，B被定为到Node B上，C被定为到Node C上，D被定为到Node D上。</p>
<h2 id="容错性和可扩展性"><strong>容错性和可扩展性</strong></h2>
<p>现假设Node C不幸宕机，可以看到此时对象A、B、D不会受到影响，只有C对象被重定位到Node D。一般的，在一致性Hash算法中，<strong>如果一台服务器不可用，则受影响的数据仅仅是此服务器到其环空间中前一台服务器（即沿着逆时针方向行走遇到的第一台服务器）之间数据</strong>，其它不会受到影响，如下所示：</p>
<figure data-type="image" tabindex="4"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200825173823.jpg" alt="img" loading="lazy"></figure>
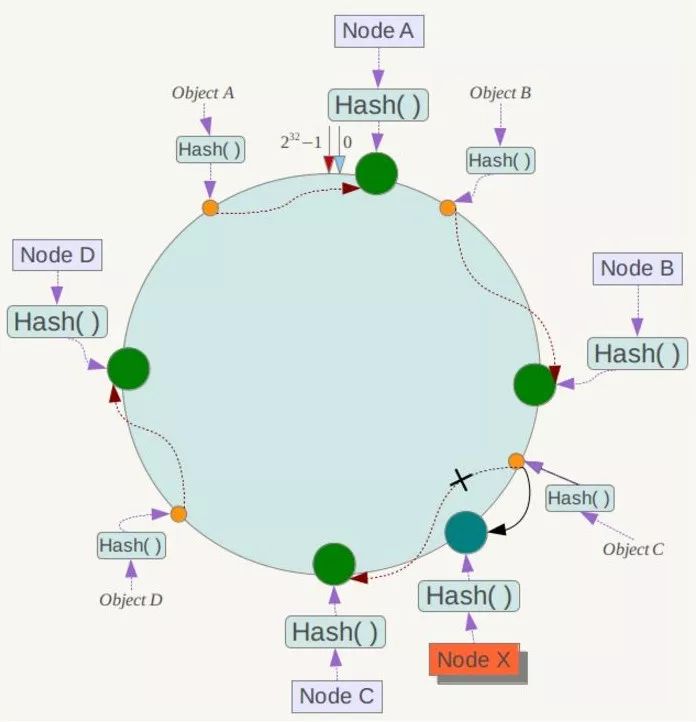
<p>下面考虑另外一种情况，如果在系统中增加一台服务器Node X，如下图所示：</p>
<figure data-type="image" tabindex="5"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200825173851.jpg" alt="img" loading="lazy"></figure>
<p>此时对象Object A、B、D不受影响，只有对象C需要重定位到新的Node X ！一般的，在一致性Hash算法中，<strong>如果增加一台服务器，则受影响的数据仅仅是新服务器到其环空间中前一台服务器</strong>（即沿着逆时针方向行走遇到的第一台服务器）<strong>之间数据</strong>，其它数据也不会受到影响。</p>
<p>综上所述，一致性Hash算法对于节点的增减都只需重定位环空间中的一小部分数据，具有较好的容错性和可扩展性。</p>
<h2 id="hash环的数据倾斜问题"><strong>Hash环的数据倾斜问题</strong></h2>
<p>一致性Hash算法在服务节点太少时，容易因为节点分部不均匀而造成数据倾斜（被缓存的对象大部分集中缓存在某一台服务器上）问题，例如系统中只有两台服务器，其环分布如下：</p>
<figure data-type="image" tabindex="6"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200825173915.jpg" alt="img" loading="lazy"></figure>
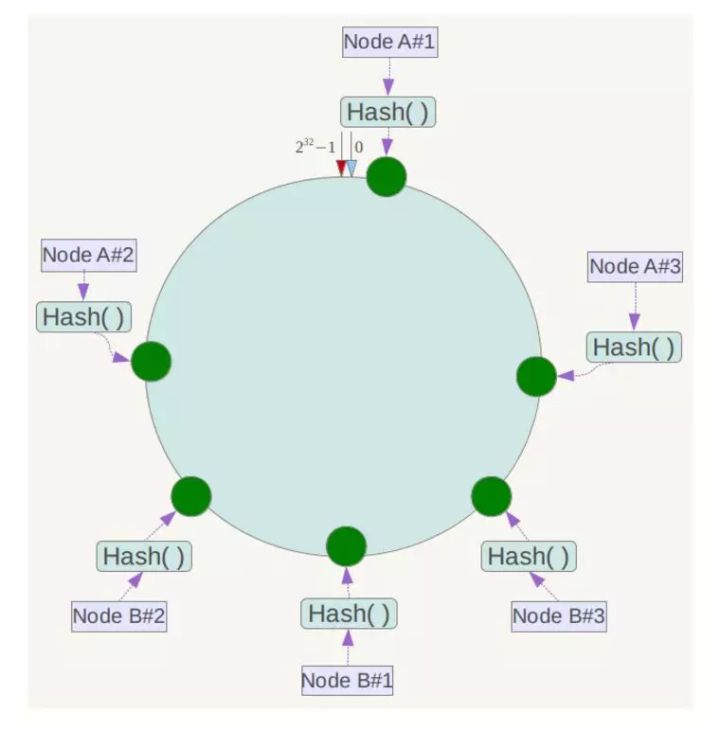
<p>此时必然造成大量数据集中到Node A上，而只有极少量会定位到Node B上。为了解决这种数据倾斜问题，一致性Hash算法引入了虚拟节点机制，即对每一个服务节点计算多个哈希，每个计算结果位置都放置一个此服务节点，称为虚拟节点。具体做法可以在服务器IP或主机名的后面增加编号来实现。</p>
<p>例如上面的情况，可以为每台服务器计算三个虚拟节点，于是可以分别计算 “Node A#1”、“Node A#2”、“Node A#3”、“Node B#1”、“Node B#2”、“Node B#3”的哈希值，于是形成六个虚拟节点：</p>
<figure data-type="image" tabindex="7"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20200825173908.jpg" alt="img" loading="lazy"></figure>
<p>同时数据定位算法不变，只是多了一步虚拟节点到实际节点的映射，例如定位到“Node A#1”、“Node A#2”、“Node A#3”三个虚拟节点的数据均定位到Node A上。这样就解决了服务节点少时数据倾斜的问题。<strong>在实际应用中，通常将虚拟节点数设置为32甚至更大，因此即使很少的服务节点也能做到相对均匀的数据分布。</strong></p>
<h2 id="参考链接">参考链接</h2>
<p><a href="https://zhuanlan.zhihu.com/p/34985026">面试必备：什么是一致性Hash算法？</a></p>
<p>https://juejin.im/post/5ae1476ef265da0b8d419ef2</p>
<p>http://blog.huanghao.me/?p=14</p>
<p>https://reishin.me/python-consistent-hash/</p>
]]></content>
    </entry>
    <entry>
        <title type="html"><![CDATA[初始 Hugo]]></title>
        <id>https://Littlecowherd.github.io/post/R-OzPVSh7/</id>
        <link href="https://Littlecowherd.github.io/post/R-OzPVSh7/">
        </link>
        <updated>2020-03-09T09:40:04.000Z</updated>
        <content type="html"><![CDATA[<h2 id="安装及主题配置">安装及主题配置</h2>
<ol>
<li>
<p>推荐使用 scoop 安装 Hugo</p>
<pre><code class="language-bash"># 普通版
scoop install hugo
# 扩展版
scoop install hugo-extended
</code></pre>
<p>在后续使用过程中，如果出现以下报错，可以通过安装扩展版解决。 <sup class="footnote-ref"><a href="#fn1" id="fnref1">[1]</a></sup></p>
<pre><code class="language-bash">error: failed to transform resource: TOCSS: failed to transform &quot;scss/main.scss&quot; (text/x-scss): this feature is not available in your current Hugo version
</code></pre>
</li>
<li>
<p>生成站点</p>
<p>​	<code>hugo new site path/to/your/blog</code></p>
</li>
<li>
<p>安装主题 MemE <sup class="footnote-ref"><a href="#fn2" id="fnref2">[2]</a></sup></p>
<pre><code class="language-bash"># 安装
cd blog
git init
git submodule add https://github.com/reuixiy/hugo-theme-meme.git themes/meme

# 更新
git submodule update --rebase --remote
</code></pre>
</li>
<li>
<p>配置主题</p>
<ol>
<li>
<p>替换 config.toml</p>
<p>打开站点文件夹，然后将 Hugo 默认生成的 <code>config.toml</code> 删除，再进入 <code>themes/meme/config-examples/zh-cn/</code> 目录，将 MemE 提供的 <code>config.toml</code> 复制到站点根目录下</p>
</li>
<li>
<p>新建文章</p>
<pre><code class="language-sh">hugo new &quot;posts/hello-world.md&quot;
hugo new &quot;about/_index.md&quot;
</code></pre>
</li>
<li>
<p>体验测试</p>
<pre><code class="language-sh">hugo server -D
</code></pre>
</li>
</ol>
</li>
</ol>
<h2 id="个性化">个性化</h2>
<p>根据配置文件中的注释安装自己的需要配置即可，下面着重介绍下“品牌栏”的配置。</p>
<ul>
<li><a href="http://www.diyiziti.com/builder/90">这个网站</a>可以生成艺术字图片</li>
<li><a href="https://www.aconvert.com/cn/image/png-to-svg/">这个网站</a>可以将图片转成 SVG 格式</li>
<li><a href="https://jakearchibald.github.io/svgomg/">这个网站</a>可以压缩 SVG 文件</li>
</ul>
<p>这个流程走下来，brand 就做好了，接下来把它用到主题中。</p>
<p>打开你的 SVG文件，给它添加一个名为 <code>brand</code> 的 <code>class</code>，比如：</p>
<pre><code class="language-diff"># 修改前
- &lt;svg xmlns=&quot;http://www.w3.org/2000/svg&quot;&gt;
# 修改后
+ &lt;svg xmlns=&quot;http://www.w3.org/2000/svg&quot; class=&quot;brand&quot;&gt;
</code></pre>
<p>接下来，在站点的 <code>data</code> 文件夹内新建一个 <code>SVG.toml</code> 文件，并添加一行：</p>
<pre><code class="language-toml">brand = ''
</code></pre>
<p>最后，将你的 SVG 粘贴进 <code>''</code> 内即可。</p>
<h2 id="参考文档">参考文档</h2>
<p><a href="https://io-oi.me/tech/documentation-of-hugo-theme-meme/">Hugo 主题 MemE 文档</a></p>
<hr class="footnotes-sep">
<section class="footnotes">
<ol class="footnotes-list">
<li id="fn1" class="footnote-item"><p>https://gohugo.io/troubleshooting/faq/#i-get-tocss--this-feature-is-not-available-in-your-current-hugo-version <a href="#fnref1" class="footnote-backref">↩︎</a></p>
</li>
<li id="fn2" class="footnote-item"><p>https://github.com/reuixiy/hugo-theme-meme/blob/master/README.zh-cn.md <a href="#fnref2" class="footnote-backref">↩︎</a></p>
</li>
</ol>
</section>
]]></content>
    </entry>
    <entry>
        <title type="html"><![CDATA[用 Supervisor 守护你的进程]]></title>
        <id>https://Littlecowherd.github.io/post/03ovubxPi/</id>
        <link href="https://Littlecowherd.github.io/post/03ovubxPi/">
        </link>
        <updated>2019-09-29T08:55:05.000Z</updated>
        <content type="html"><![CDATA[<h2 id="1-简介">1. 简介</h2>
<blockquote>
<p>Supervisor is a client/server system that allows its users to monitor and control a number of processes on UNIX-like operating systems.</p>
</blockquote>
<p>Supervisor是一个客户端/服务器系统，能够帮助用户监控和管理运行在类 UNIX 系统上的进程。</p>
<h2 id="2-安装">2. 安装</h2>
<p><strong>两种安装方式</strong></p>
<ol>
<li>
<p>通过 pip 安装（推荐）</p>
<pre><code class="language-bash">pip install supervisor
</code></pre>
</li>
<li>
<p>通过发行包直接安装</p>
<pre><code class="language-bash"># ubuntu Debian
apt install supervisor
# Centos Redhat 
yum install supervisor
</code></pre>
</li>
</ol>
<h2 id="3-使用">3. 使用</h2>
<ol>
<li>
<p>生成默认配置</p>
<pre><code class="language-bash">echo_supervisord_conf &gt; /etc/supervisord.conf
</code></pre>
</li>
<li>
<p>修改默认配置</p>
<pre><code class="language-bash">vim /etc/supervisord.conf
</code></pre>
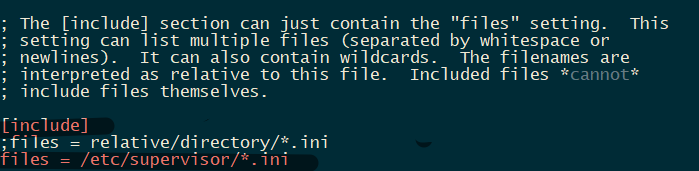
<p><strong>跳到最后，修改以下几行：</strong>（千万不要忽视了<code>[include]</code>前面的分号！）</p>
<pre><code class="language-ini">;[include]
;files = /etc/supervisor/*.ini
</code></pre>
<p>去掉开头的 “ ; ”，使这两行生效。（<strong>一定注意，这两行都要取消注释！</strong>）</p>
<figure data-type="image" tabindex="1"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20190929163952.png" alt="" loading="lazy"></figure>
<p>这两行的作用就是，将<code>/etc/supervisor/</code>目录下所有的<code>.ini</code>文件都包含到这个配置文件里来。</p>
</li>
<li>
<p>编写自己的配置</p>
<p>进入<code>/etc/supervisor/</code>目录，编写自己的配置文件</p>
<pre><code>vim myCelery.ini
</code></pre>
<p>配置文件内容实例（如需了解配置文件的含义，请查看官方文档）</p>
<pre><code class="language-ini">[program:mp_celery]  # 这个是进程的名字，随意起
command=/root/test/venv/bin/celery -B -A Platform worker -l info  # 要运行的命令
directory=/root/mpform/Platform  # 运行命令的目录

numprocs=1
# 设置log的路径
stdout_logfile=/var/log/supervisor/mp_celery.log
stderr_logfile=/var/log/supervisor/mp_celery_error.log
autostart=true
autorestart=true
startsecs=10
stopwaitsecs = 10
priority=15
</code></pre>
</li>
<li>
<p>启动 Supervisor</p>
<pre><code class="language-bash"># supervisord -c /path/to/config
supervisord -c /etc/supervisord.conf
</code></pre>
</li>
<li>
<p>查看执行状态</p>
<pre><code>supervisorctl
</code></pre>
<figure data-type="image" tabindex="2"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20190929164908.png" alt="" loading="lazy"></figure>
<p>如果输出结果如上图，就说明成功了。</p>
<p>如果不是这样的，可以去<code>/var/log/supervisor</code>目录下查看日志，是不是有什么错误。</p>
<p>常用命令</p>
<pre><code class="language-bash">status       # 查看状态
reread       # 读取配置信息
update       # 加载最新的进程
stop         # 停止进程
start        # 启动进程
reload       # 重新加载配置
</code></pre>
</li>
</ol>
<h2 id="参考链接">参考链接</h2>
<ol>
<li><a href="http://supervisord.org/">Supervisor 官方文档</a></li>
<li><a href="https://www.jianshu.com/p/222d85c3833e">使用supervisor后台运行celery</a></li>
</ol>
]]></content>
    </entry>
    <entry>
        <title type="html"><![CDATA[ 关于Requests代理，你必须知道的]]></title>
        <id>https://Littlecowherd.github.io/post/JdmtOALbL/</id>
        <link href="https://Littlecowherd.github.io/post/JdmtOALbL/">
        </link>
        <updated>2019-08-21T02:55:55.000Z</updated>
        <content type="html"><![CDATA[<p>说到代理，写过爬虫的小伙伴一定都不陌生。但是<strong>你的代理真的生效了么</strong>？</p>
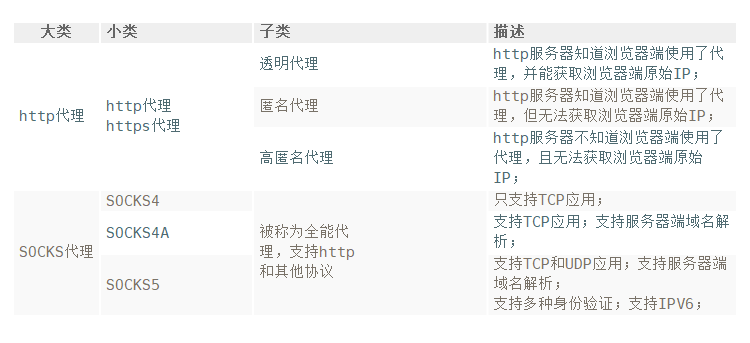
<p>代理主要分为以下几类：</p>
<figure data-type="image" tabindex="1"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20190819105520.png" alt="代理分类" loading="lazy"></figure>
<p>如果是爬虫的话，最常见的选择是高匿代理。</p>
<p>Requests 设置代理非常方便，只需传递一个 proxies 参数即可。如官方示例：</p>
<pre><code class="language-Python">import requests

proxies = {
  'http': 'http://10.10.1.10:3128',
  'https': 'http://10.10.1.10:1080',
}

requests.get('http://example.org', proxies=proxies)
</code></pre>
<p>留意一个地方，proxies 字典中有两个 key ：https 和 http，为什么要写两个 key，如果只有一个可以么？</p>
<h2 id="试试就知道了">试试就知道了</h2>
<h3 id="准备验证函数">准备验证函数</h3>
<p>这个函数会使用代理去访问两个 IP 验证网站，一个是 https，一个是 http。</p>
<pre><code class="language-Python">import requests
from bs4 import BeautifulSoup


def validate(proxies):
    https_url = 'https://ip.cn'
    http_url = 'http://ip111.cn/'
    headers = {'User-Agent': 'curl/7.29.0'}
    https_r = requests.get(https_url, headers=headers, proxies=proxies, timeout=10)
    http_r = requests.get(http_url, headers=headers, proxies=proxies, timeout=10)
    soup = BeautifulSoup(http_r.content, 'html.parser')
    result = soup.find(class_='card-body').get_text().strip().split('''\n''')[0]

    print(f&quot;当前使用代理：{proxies.values()}&quot;)
    print(f&quot;访问https网站使用代理：{https_r.json()}&quot;)
    print(f&quot;访问http网站使用代理：{result}&quot;)
</code></pre>
<h3 id="测试">测试</h3>
<ul>
<li>
<p>Case 1</p>
<pre><code class="language-Python">proxies = {
    'http': '222.189.244.56:48304',
    'https': '222.189.244.56:48304'
}
validate(proxies)
</code></pre>
<p>输出</p>
<pre><code>当前使用代理：dict_values(['222.189.244.56:48304', '222.189.244.56:48304'])
访问https网站使用代理：{'ip': '222.189.244.56', 'country': '江苏省扬州市', 'city': '电信'}
访问http网站使用代理：222.189.244.56 China / Nanjing
</code></pre>
<p>结果： <em>访问两个网站均使用了代理</em></p>
</li>
<li>
<p>Case 2</p>
<pre><code class="language-python">proxies = {
    'http': '222.189.244.56:48304'
}
validate(proxies)
</code></pre>
<p>输出</p>
<pre><code>当前使用代理：dict_values(['222.189.244.56:48304'])
访问https网站使用代理：{'ip': '118.24.234.46', 'country': '重庆市', 'city': '腾讯'}
访问http网站使用代理：222.189.244.56 China / Nanjing
</code></pre>
<p>结果： <em>只有http请求使用了代理</em></p>
</li>
<li>
<p>Case 3</p>
<pre><code class="language-python">proxies = {
    'https': '222.189.244.56:48304'
}
validate(proxies)
</code></pre>
<p>输出</p>
<pre><code>当前使用代理：dict_values(['222.189.244.56:48304'])
访问https网站使用代理：{'ip': '222.189.244.56', 'country': '江苏省扬州市', 'city': '电信'}
访问http网站使用代理：118.24.234.46 China / Nanning
</code></pre>
<p>结果： <em>只有https请求使用了代理</em></p>
</li>
</ul>
<h3 id="其他测试">其他测试</h3>
<p>通过 wireshark 抓包发现，当协议不匹配时，根本不会向代理服务器发起请求。</p>
<p>通过 postman 测试，结果与 Requests 一致，协议不同的情况下，不会走代理。</p>
<p><s>猜测可能是一种约定或者规则，类似 PAC ？（如果你知道答案，请告诉我）</s></p>
<h2 id="寻找答案">寻找答案</h2>
<p>从源码入手试试？在<code>requests.ultis</code> 中找到了这个函数：</p>
<pre><code class="language-Python">def select_proxy(url, proxies):
    &quot;&quot;&quot;Select a proxy for the url, if applicable.

    :param url: The url being for the request
    :param proxies: A dictionary of schemes or schemes and hosts to proxy URLs
    &quot;&quot;&quot;
    proxies = proxies or {}
    urlparts = urlparse(url)
    if urlparts.hostname is None:
        return proxies.get(urlparts.scheme, proxies.get('all'))

    proxy_keys = [
        urlparts.scheme + '://' + urlparts.hostname,
        urlparts.scheme,
        'all://' + urlparts.hostname,
        'all',
    ]
    proxy = None
    for proxy_key in proxy_keys:
        if proxy_key in proxies:
            proxy = proxies[proxy_key]
            break

    return proxy
</code></pre>
<p>答案揭晓了，<strong>Requests 会根据目标 url 的协议按照一定顺序来为它选择代理。</strong> 就拿上面的 Case 2 来说：</p>
<pre><code class="language-Python">proxies = {
    'http': '222.189.244.56:48304'
}
</code></pre>
<p>请求<code>http://ip111.cn/</code>时，按照以下顺序在 proxies 字典中为这个链接选用代理：</p>
<ol>
<li>协议+域名 ：<code>http://ip111.cn</code></li>
<li>协议：<code>http</code></li>
<li>all + 域名：<code>all://ip111.cn</code></li>
<li>all：<code>all</code></li>
</ol>
<p>在第 2 步匹配到<code>222.189.244.56:48304</code>，然后就使用这个代理去访问目标地址。</p>
<p>而在请求<code>https://ip.cn</code>时，按照上面顺序匹配不到任何内容，就使用本地的 ip 去访问目标地址了。</p>
<p>这样也就能说明上面 3 个例子了。</p>
<h2 id="扩展">扩展</h2>
<p>官方示例中的代理包含协议，而我们测试的例子中没有但同样能够成功访问。这又是为什么呢？</p>
<pre><code class="language-Python"># 官方的
proxies = {
  'http': 'http://10.10.1.10:3128',
  'https': 'http://10.10.1.10:1080',
}
# 我们的
proxies = {
    'http': '222.189.244.56:48304',
    'https': '222.189.244.56:48304'
}
</code></pre>
<p>答案同样可以在源码里找到，请看下面这两个函数：</p>
<p><code>requests.apdpters</code></p>
<pre><code class="language-Python">def get_connection(self, url, proxies=None):
    &quot;&quot;&quot;Returns a urllib3 connection for the given URL. This should not be
    called from user code, and is only exposed for use when subclassing the
    :class:`HTTPAdapter &lt;requests.adapters.HTTPAdapter&gt;`.

    :param url: The URL to connect to.
    :param proxies: (optional) A Requests-style dictionary of proxies used on this request.
    :rtype: urllib3.ConnectionPool
    &quot;&quot;&quot;
    proxy = select_proxy(url, proxies)

    if proxy:
        proxy = prepend_scheme_if_needed(proxy, 'http')
        proxy_url = parse_url(proxy)
        if not proxy_url.host:
            raise InvalidProxyURL(&quot;Please check proxy URL. It is malformed&quot;
                                    &quot; and could be missing the host.&quot;)
        proxy_manager = self.proxy_manager_for(proxy)
        conn = proxy_manager.connection_from_url(url)
    else:
        # Only scheme should be lower case
        parsed = urlparse(url)
        url = parsed.geturl()
        conn = self.poolmanager.connection_from_url(url)

    return conn
</code></pre>
<p>看这一行代码：<code>proxy = prepend_scheme_if_needed(proxy, 'http')</code>，找到这个函数的定义:</p>
<pre><code class="language-python">def prepend_scheme_if_needed(url, new_scheme):
    &quot;&quot;&quot;Given a URL that may or may not have a scheme, prepend the given scheme.
    Does not replace a present scheme with the one provided as an argument.

    :rtype: str
    &quot;&quot;&quot;
    scheme, netloc, path, params, query, fragment = urlparse(url, new_scheme)

    # urlparse is a finicky beast, and sometimes decides that there isn't a
    # netloc present. Assume that it's being over-cautious, and switch netloc
    # and path if urlparse decided there was no netloc.
    if not netloc:
        netloc, path = path, netloc

    return urlunparse((scheme, netloc, path, params, query, fragment))
</code></pre>
<p>从注释中可以找到答案：</p>
<p><strong>如果代理提供了协议，不做改变；如果代理没有协议的话，就为代理加上<code>http</code>协议。</strong></p>
<h2 id="结论">结论</h2>
<ol>
<li>Requests 会按照目标url的协议来为它配置代理。基于此你可以为不同的协议甚至不同域名设置不同的代理，如果想为所有请求使用同一个代理，那直接使用 all 作为 key 来设置即可。</li>
<li>代理地址如果没有指明协议，则默认使用 http 请求。</li>
</ol>
<h2 id="参考链接">参考链接</h2>
<ul>
<li><a href="https://imququ.com/post/web-proxy.html">HTTP 代理原理及实现（一）</a></li>
<li><a href="https://imququ.com/post/web-proxy-2.html">HTTP 代理原理及实现（二）</a></li>
<li><a href="https://blog.51cto.com/14062184/2315723">什么是透明、匿名、高匿代理？详解！</a></li>
<li><a href="https://www.hitoy.org/difference-between-http-and-https-proxy.html">HTTP代理和HTTPS代理的区别</a></li>
</ul>
]]></content>
    </entry>
    <entry>
        <title type="html"><![CDATA[删除Git仓库的所有历史提交记录]]></title>
        <id>https://Littlecowherd.github.io/post/ko1lNI3Ex/</id>
        <link href="https://Littlecowherd.github.io/post/ko1lNI3Ex/">
        </link>
        <updated>2019-08-08T10:53:23.000Z</updated>
        <content type="html"><![CDATA[<p>在开发项目过程中，很可能在提交 git  时泄露了一些敏感信息，本地尚且无妨。倘若要同步到 GitHub 等公开平台，那就一定要消除这些信息。</p>
<p><strong>操作方式如下：</strong></p>
<blockquote>
<p>Deleting the <code>.git</code> folder may cause problems in your git repository. If you want to delete all your commit history but keep the code in its current state, it is very safe to do it as in the following:</p>
<p>删除 .git 文件夹可能会导致 git 存储库出现问题。如果要删除所有提交历史记录但保持代码处于当前状态，则执行此操作非常安全，如下所示：</p>
<ol>
<li>
<p>Checkout</p>
<p><code>git checkout --orphan latest_branch</code></p>
</li>
<li>
<p>Add all the files</p>
<p><code>git add -A</code></p>
</li>
<li>
<p>Commit the changes</p>
<p><code>git commit -am &quot;commit message&quot;</code></p>
</li>
<li>
<p>Delete the branch</p>
<p><code>git branch -D master</code></p>
</li>
<li>
<p>Rename the current branch to master</p>
<p><code>git branch -m master</code></p>
</li>
<li>
<p>Finally, force update your repository</p>
<p><code>git push -f origin master</code></p>
</li>
</ol>
<p>PS: this will not keep your old commit history around</p>
</blockquote>
<p>这组命令对于发布开源分支来说很有帮助，新的分支含有之前的全部代码但不包含之前的提交记录，就算你不小心把敏感信息提交到了 GitHub，也可以用它来亡羊补牢。</p>
<p><strong>命令说明</strong></p>
<blockquote>
<p><code>git checkout --orphan &lt;new_branch&gt;</code></p>
<p>Create a new <em>orphan</em> branch, named &lt;new_branch&gt;, started from &lt;start_point&gt; and switch to it. The first commit made on this new branch will have no parents and it will be the root of a new history totally disconnected from all the other branches and commits.</p>
<p>创建一个名为 &lt;new_branch&gt; 的新<em>孤立</em>分支，从 &lt;start_point&gt; 启动并切换到该分支。在这个新分支上进行的第一次提交将没有父项，它将成为与所有其他分支和提交完全断开的新历史的根。</p>
</blockquote>
<p>大致意思就是：创建一个名为  &lt;new_branch&gt;  的 全新的<em>孤立</em>分支，可以当成一个全新的根节点。</p>
<p><strong>参考链接</strong></p>
<ol>
<li>
<p><a href="https://stackoverflow.com/questions/13716658/how-to-delete-all-commit-history-in-github">how to delete all commit history in github? </a></p>
</li>
<li>
<p><a href="https://www.jianshu.com/p/cad4d2ec4da5">Git checkout 用法总结</a></p>
</li>
<li>
<p><a href="https://git-scm.com/docs/git-checkout#Documentation/git-checkout.txt---orphanltnewbranchgt">checkout - Git 官方文档</a></p>
</li>
</ol>
]]></content>
    </entry>
    <entry>
        <title type="html"><![CDATA[py-spy 常见问题及使用说明]]></title>
        <id>https://Littlecowherd.github.io/post/TICCX3MX-/</id>
        <link href="https://Littlecowherd.github.io/post/TICCX3MX-/">
        </link>
        <updated>2019-08-01T10:35:09.000Z</updated>
        <content type="html"><![CDATA[<h2 id="常见问题">常见问题</h2>
<h3 id="failed-to-suspend-process">Failed to suspend process</h3>
<p>上篇文章说到了通过 py-spy 来分析Python进程，进而找到程序中的问题。有小伙伴在使用的时候遇到了这样的错误：</p>
<pre><code class="language-bash">[test@localhost]# py-spy --pid 15235
Error: Failed to suspend process
Reason: EPERM: Operation not permitted
</code></pre>
<p>先看下报错信息：暂停进程失败，原因是操作不允许。</p>
<p>百度\Google 一下，相关结果只有两条，并不能解决问题。</p>
<figure data-type="image" tabindex="1"><img src="https://Littlecowherd.github.io/post-images/1564652166145.png" alt="" loading="lazy"></figure>
<p>这个时候别慌，去看<a href="https://github.com/benfred/py-spy">官方文档</a>，虽然是英文写的，但是读起来并不会特别困难，实在不行就用翻译插件。</p>
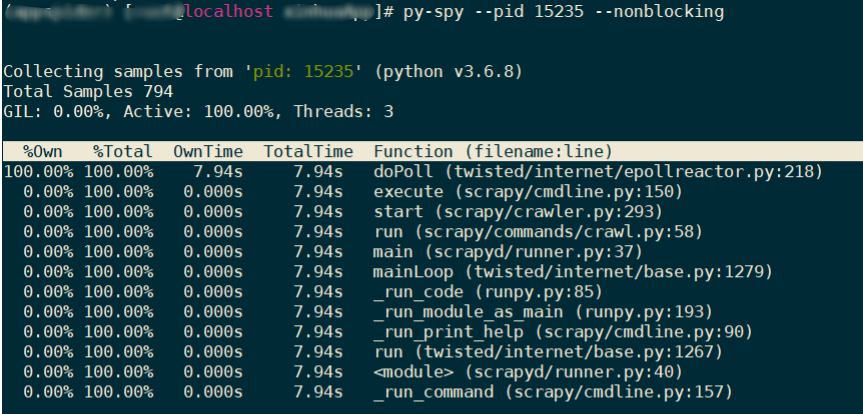
<p>果然找到了一条相关的，在命令中加入 <code>--nonblocking</code>参数就可以避免暂停 Python 进程。</p>
<blockquote>
<h3 id="how-can-you-avoid-pausing-the-python-program">How can you avoid pausing the Python program?</h3>
<p>By setting the <code>--nonblocking</code> option, py-spy won't pause the target python you are profiling from. While the performance impact of sampling from a process with py-spy is usually extremely low, setting this option will totally avoid interrupting your running python program.</p>
</blockquote>
<p>尝试一下，果然可以了。</p>
<figure data-type="image" tabindex="2"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown20190731104040.png" alt="" loading="lazy"></figure>
<p>官方文档中还有在 Docker、Kubernetes 环境下运行的特殊说明、OS X 环境下的特殊问题等，可能暂时用不到，但是一定要了解。等到用的时候知道有这么回事，知道去哪里找解决方法。</p>
<p><mark>我只是把我遇到的问题写了出来，如果你遇到了其他问题，强烈建议你去读一下官方文档。</mark></p>
<h2 id="常用命令">常用命令</h2>
<p><strong>监控 Python 进程</strong></p>
<pre><code class="language-bash">py-spy --pid 12345
# OR
py-spy -- python myprogram.py
</code></pre>
<p><em>注意，如果直接通过 pid 参数来运行 py-spy 需要用到 root 权限。第二种启动方法会将 Python 进程以 py-spy子进程的形式启动，故而不需要 root 权限</em></p>
<p><strong>绘制火焰图</strong></p>
<pre><code class="language-bash">py-spy --flame profile.svg --pid 12345
# OR
py-spy --flame profile.svg -- python myprogram.py
</code></pre>
<p><em>注意，图片的类型一定得是 svg</em></p>
<h2 id="小结">小结</h2>
<p>遇到问题，可能很多人的第一反应都是去求助搜索引擎，这种方法对应某些情况来说的确很好用（比如说，这个工具用的人很多，有很多人都遇到过类似的问题）。但像这次，相关的结果很少，那一定要去看看官方文档，如果官方文档任然不能解决你的问题，还可以去提 issue（一定要把问题说清楚，啥环境、什么问题，以及你的目的等等）。阅读源码当然也是一个途径。</p>
<p>官方文档，永远是帮我们了解某个工具的最好途径之一，甚至可以去掉之一。</p>
<h2 id="参考信息">参考信息</h2>
<ol>
<li><a href="https://github.com/benfred/py-spy">py-spy 官方文档</a></li>
<li><a href="https://github.com/ryanhanwu/How-To-Ask-Questions-The-Smart-Way/blob/master/README-zh_CN.md">提问的智慧</a></li>
</ol>
]]></content>
    </entry>
    <entry>
        <title type="html"><![CDATA[ 记一次Scrapy进程卡死的Debug过程]]></title>
        <id>https://Littlecowherd.github.io/post/ji-yi-ci-scrapy-jin-cheng-qia-si-de-debug-guo-cheng/</id>
        <link href="https://Littlecowherd.github.io/post/ji-yi-ci-scrapy-jin-cheng-qia-si-de-debug-guo-cheng/">
        </link>
        <updated>2019-07-30T06:41:09.000Z</updated>
        <content type="html"><![CDATA[<h2 id="发现问题">发现问题</h2>
<p>日常巡查数据入库情况时，发现最新数据的入库时间停在了凌晨。立刻登录远程服务器，尝试定位问题。</p>
<ol>
<li>
<p>定时任务是否正常工作，是否有报错信息</p>
<pre><code>crontab -l
</code></pre>
<p>经检查发现，定时任务工作正常，也没有运行报错的记录。</p>
</li>
<li>
<p>查看系统进程，采集程序是否运行</p>
<pre><code>ps -ef | grep xxxappspider
</code></pre>
<p>输出信息如下</p>
<figure data-type="image" tabindex="1"><img src="https://Littlecowherd.github.io/post-images/1564469201050.png" alt="" loading="lazy"></figure>
<p>可以看到进程在凌晨 01:40 成功启动了，但是一直没有执行完成，推测是代码出现了死锁等问题？查看日志也没有记录到有用的信息。</p>
</li>
<li>
<p>检查代码，尝试复现该bug</p>
<p>在服务器手动执行程序，均能正常运行。简单复查代码，也没有发现哪里会导致死锁。</p>
</li>
</ol>
<h2 id="解决问题">解决问题</h2>
<p>由于手头还有比较急的任务，只是给程序加上了更详细的日志记录，然后 kill 掉卡住的进程，让定时任务重新运行起来。</p>
<p>第二天问题再次出现，同样是凌晨的定时任务出现了卡死的情况。首先排除服务器原因，相同服务器其他任务均正常运行。其次排除存储原因，我们的采集结果是统一入到 Kafka 队列，经过一系列的操作后存储到数据库的。这个 Kafka 队列所有应用都在使用，如果出现问题不会只这一个任务。然后大致可以确定，是这个任务在<strong>凌晨</strong>运行时，会因为某些原因导致卡死。</p>
<p>好了，是时候祭出我们的大杀器： <a href="https://github.com/benfred/py-spy">py-spy</a></p>
<p>这是一个 Python 的性能分析工具，我是在听<a href="https://pythonhunter.org/">《捕蛇者说》</a>的时候了解到的这个库，现在正好拿来用用。</p>
<p>先简单看下怎么用：</p>
<pre><code class="language-bash">[test@localhost ~]# py-spy --help
py-spy 0.1.11
A sampling profiler for Python programs

USAGE:
    py-spy [FLAGS] [OPTIONS] --pid &lt;pid&gt; [python_program]...

FLAGS:
        --dump           Dump the current stack traces to stdout
    -F, --function       Aggregate samples by function name instead of by line number
    -h, --help           Prints help information
        --nonblocking    Don't pause the python process when collecting samples. Setting this option will reduce the
                         perfomance impact of sampling, but may lead to inaccurate results
    -V, --version        Prints version information

OPTIONS:
    -d, --duration &lt;duration&gt;    The number of seconds to sample for when generating a flame graph [default: 2]
    -f, --flame &lt;flamefile&gt;      Generate a flame graph and write to a file
    -p, --pid &lt;pid&gt;              PID of a running python program to spy on
    -r, --rate &lt;rate&gt;            The number of samples to collect per second [default: 100]

ARGS:
    &lt;python_program&gt;...    commandline of a python program to run

</code></pre>
<p>只需要输入 Python 进程的 pid 就能直观的显示该进程中各项任务的耗时情况。更重要的是，它<strong>不需要重启代码</strong>就能运行，非常适合我们现在遇到的情况。</p>
<p>安装很简单：</p>
<pre><code class="language-bash">pip install py-spy
</code></pre>
<p>使用很简单：</p>
<pre><code class="language-bash"># 先找到这个卡住的Python进程的pid
ps -ef |grep python |grep ***
# 启动 py-spy 观察这进程
py-spy --pid 32179
</code></pre>
<p>输出信息如下：</p>
<figure data-type="image" tabindex="2"><img src="https://Littlecowherd.github.io/post-images/1564469215602.png" alt="" loading="lazy"></figure>
<p>可以看到，程序是卡在了建立网络连接的部分。<code>hand_request</code>是一个为某个App请求签名的函数，被单独放在了<code>utils</code>这个目录下。接下来就简单了，找到这个函数，在第43行，发现了一个 post 请求。嗯，其实不管是 post 还是 get 都不要紧，重要的是这个请求没有加 <code>timeout</code> 参数！！！</p>
<p><strong>Requests 文档里写的很清楚了，如果没有超时参数，程序有可能永远失去响应。</strong></p>
<blockquote>
<h2 id="超时">超时</h2>
<p>你可以告诉 requests 在经过以 <code>timeout</code> 参数设定的秒数时间之后停止等待响应。基本上所有的生产代码都应该使用这一参数。如果不使用，你的程序可能会永远失去响应：</p>
<pre><code>&gt;&gt;&gt; requests.get('http://github.com', timeout=0.001)
Traceback (most recent call last):
  File &quot;&lt;stdin&gt;&quot;, line 1, in &lt;module&gt;
requests.exceptions.Timeout: HTTPConnectionPool(host='github.com', port=80): Request timed out. (timeout=0.001)
</code></pre>
<p>注意</p>
<p><code>timeout</code> 仅对连接过程有效，与响应体的下载无关。 <code>timeout</code> 并不是整个下载响应的时间限制，而是如果服务器在 <code>timeout</code> 秒内没有应答，将会引发一个异常（更精确地说，是在<code>timeout</code> 秒内没有从基础套接字上接收到任何字节的数据时）If no timeout is specified explicitly, requests do not time out.</p>
</blockquote>
<p>至此，Debug完成。</p>
<h2 id="总结">总结</h2>
<p>这么低级的 bug，确实是我自己写的。</p>
<p>当初写的时候忽视了这个问题，测试的时候没有发现问题也就过去了。第一次发现问题的时候，查问题并不仔细，只简单看了<code>spiders</code>目录下的几个爬虫代码，没有去检查<code>utils</code>目录下的工具类的代码，故而并没有找到具体问题。第二次通过 py-spy 的帮助，成功找到并解决了问题。</p>
<p>解决问题后，反思下原因：很可能是这个 App 会在凌晨进行维护，导致请求没有得到响应，同时没有设置超时函数，程序就会一直卡在哪里。</p>
<p>最后，推荐一下《捕蛇者说》，这是一个关于“编程、程序员、Python”的中文博客。没事听听大佬们唠嗑，真的很涨知识。</p>
<h2 id="参考链接">参考链接</h2>
<ol>
<li><a href="https://github.com/benfred/py-spy">py-spy 的官方地址</a></li>
<li><a href="https://pythonhunter.org/episodes/2">Ep 02. 开发中的碎碎念 ——《捕蛇者说》</a></li>
<li><a href="https://2.python-requests.org//zh_CN/latest/user/quickstart.html#id10">超时 ——Requests 官方文档</a></li>
</ol>
]]></content>
    </entry>
    <entry>
        <title type="html"><![CDATA[超详细CloudCone使用指南]]></title>
        <id>https://Littlecowherd.github.io/post/chao-xiang-xi-cloudcone-shi-yong-zhi-nan/</id>
        <link href="https://Littlecowherd.github.io/post/chao-xiang-xi-cloudcone-shi-yong-zhi-nan/">
        </link>
        <updated>2019-04-18T09:26:51.000Z</updated>
        <content type="html"><![CDATA[<h2 id="起因">起因</h2>
<p>相较于其他 VPS 提供商（ <a href="https://www.vultr.com/?ref=7468133">Vultr</a> 、<a href="https://m.do.co/c/b4f1eed9d029">DigitalOcean</a>、<a href="https://www.linode.com/">Linode</a> 等等），CloudCone 比较新，知名度比较低。得益于这一点，这家服务商的 IP 段在学校还能正常访问，这也是我选择它的最根本原因。</p>
<h2 id="开始试用">开始试用</h2>
<h3 id="1-注册账号">1. 注册账号</h3>
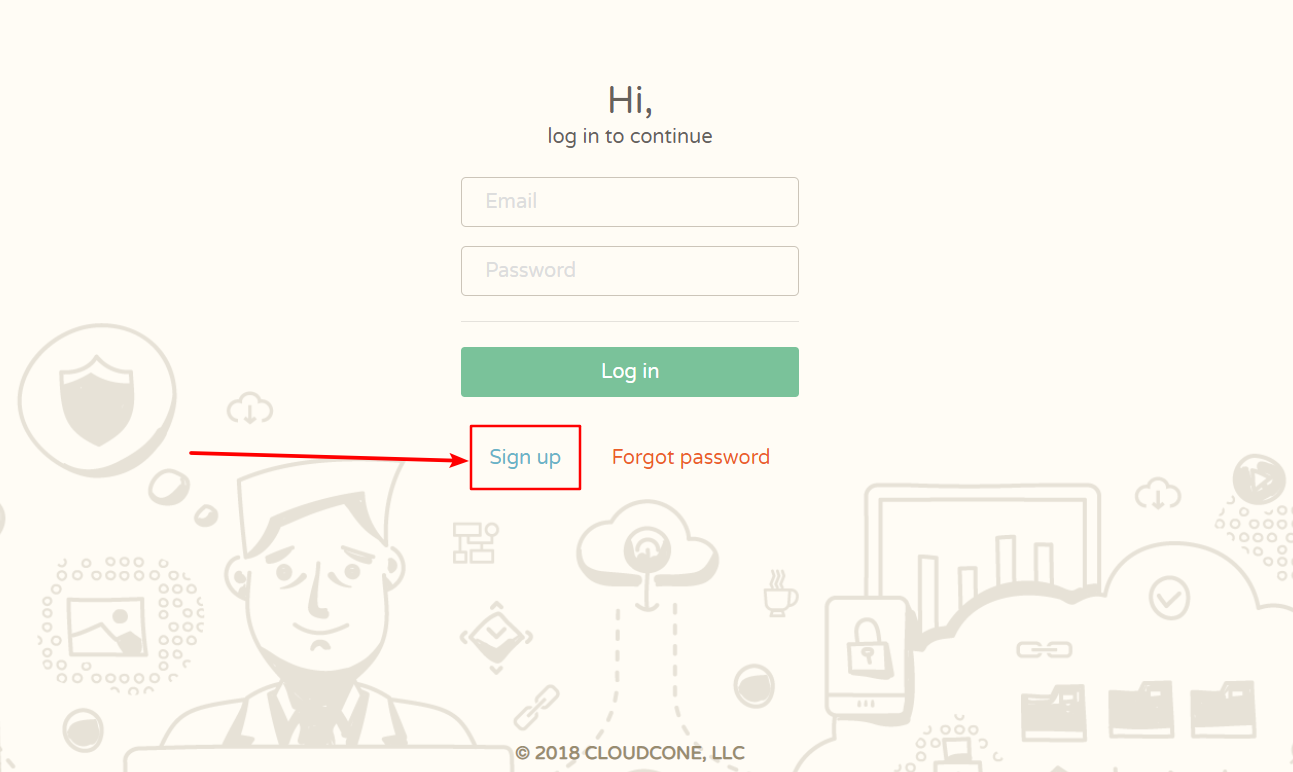
<p>你可以点击 <a href="https://app.cloudcone.com/?ref=486">CloudCone</a> 来登录或者注册，如下图所示。</p>
<figure data-type="image" tabindex="1"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220133730.png" alt="" loading="lazy"></figure>
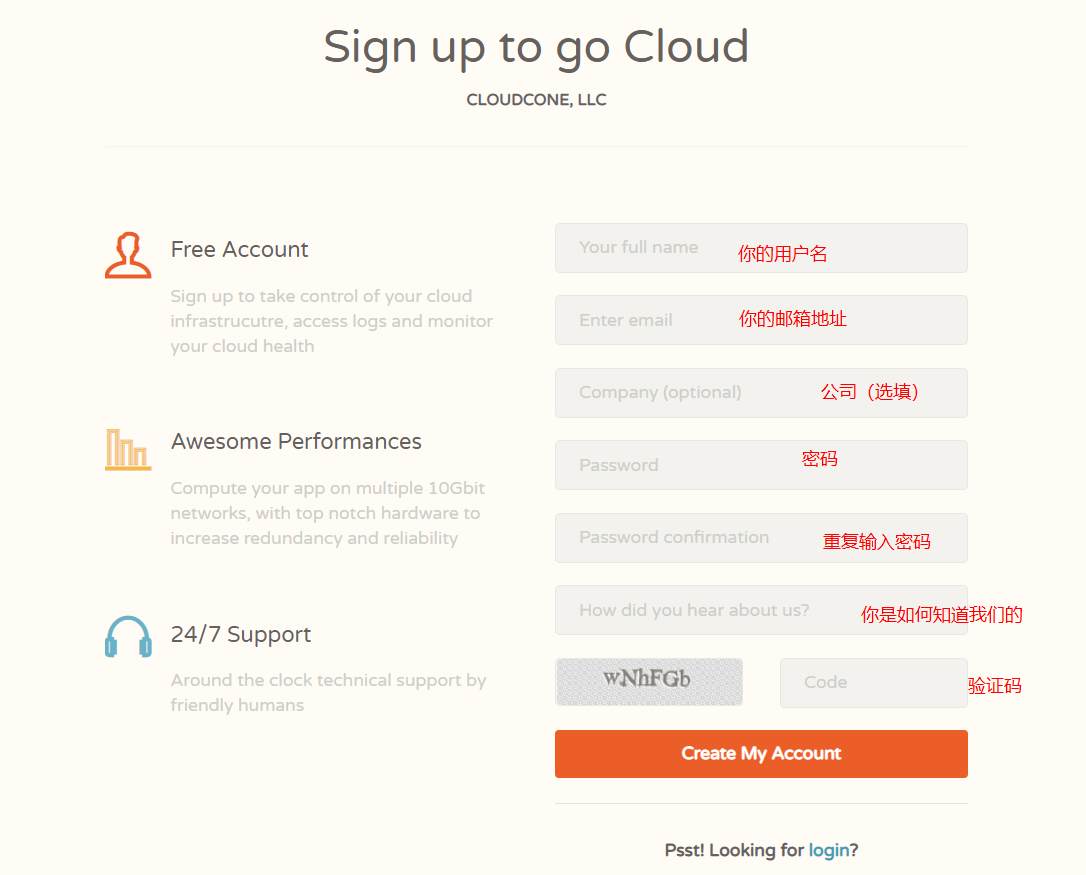
<p>如果已有账号 ，输入账号密码点击 Log in 即可登录。如果没有账号请点击 Sign up 跳转到注册界面，如下图所示。</p>
<figure data-type="image" tabindex="2"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220134049.png" alt="" loading="lazy"></figure>
<p>按照图中标识填写注册完成，点击 Create My Account 即可创建账号。</p>
<p><em>注：How did you hear about us？ 这个问题可以不填写。</em></p>
<h3 id="2-充值">2. 充值</h3>
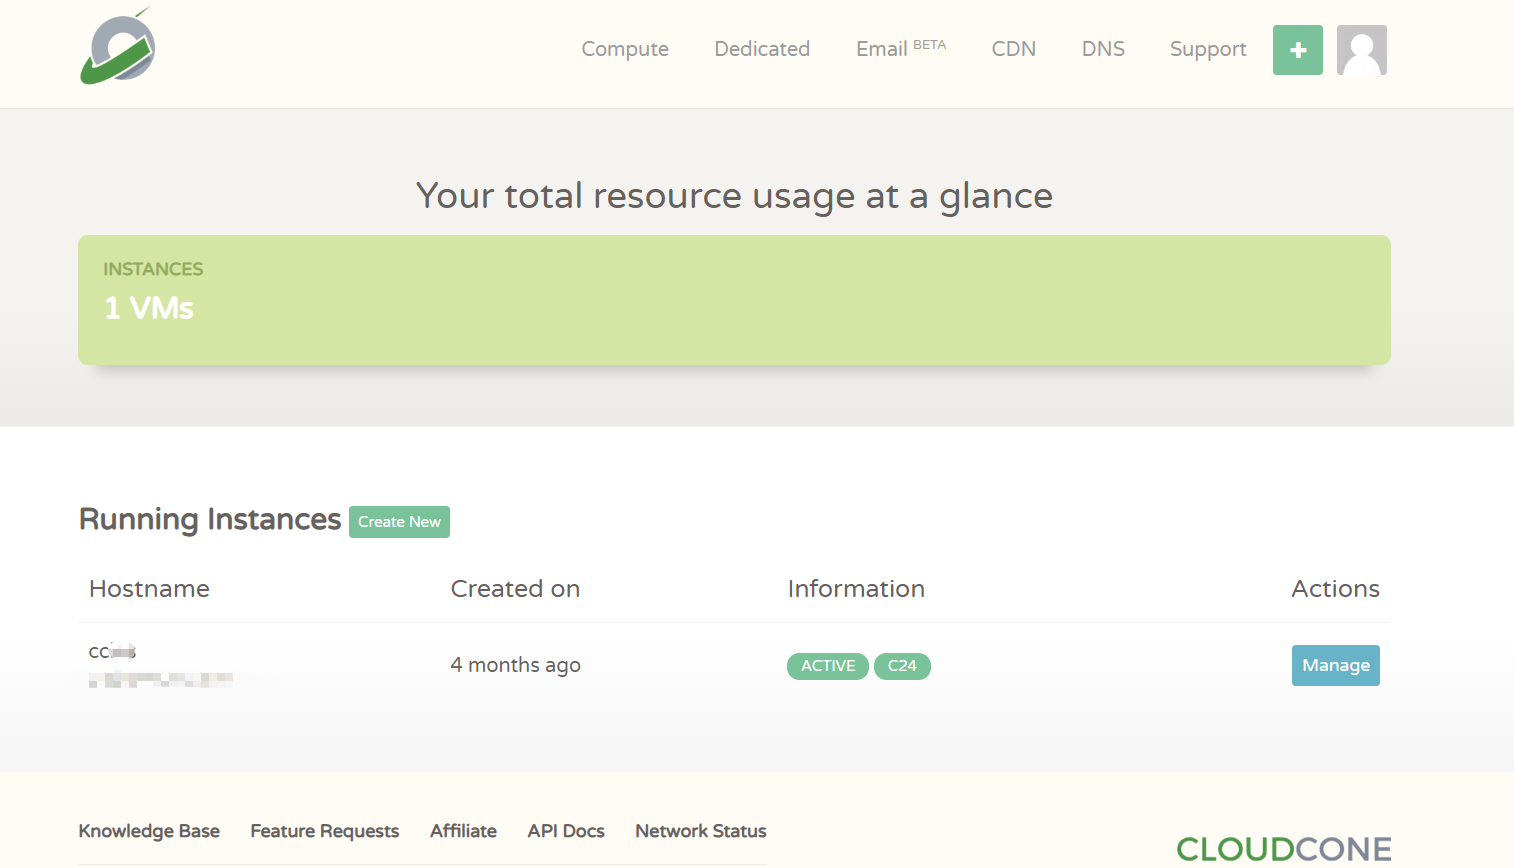
<p>注册成功，登录账号会看到如下一个界面。</p>
<figure data-type="image" tabindex="3"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220194449.png" alt="" loading="lazy"></figure>
<p>因为我已经有一台云服务器了，你看到的界面可能和我的有些不一样，但是没啥关系。</p>
<p>点击右上角的加号，选择 billing，进入充值页面，如下图所示。</p>
<figure data-type="image" tabindex="4"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220194745.png" alt="" loading="lazy"></figure>
<p>进入充值页面后选择 Add funds</p>
<figure data-type="image" tabindex="5"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220194958.png" alt="" loading="lazy"></figure>
<p>可以看到支持的充值方式为有 PayPal 和 Alipay（支付宝）等方式</p>
<figure data-type="image" tabindex="6"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220195104.png" alt="" loading="lazy"></figure>
<p>说一下这两种支付方式的区别：PayPal 可以自定义充值金额，最低充值金额是 $1，但是不够方便，可能还得注册账号绑定银行卡；支付宝要方便的多，但是最低充值金额是 $5，30 多块人民币。具体怎么选看你的喜好。</p>
<p>值得一提的是，这个页面的最下面有个 Promotional Codes，如果有优惠码的话，可以填写在这里，如下图所示。</p>
<figure data-type="image" tabindex="7"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220204412.png" alt="" loading="lazy"></figure>
<p>关于这个优惠码，我问了客服，优惠码没拿到，他倒是给了我一个促销链接。请点击<a href="https://cloudcone.com/offers">这里</a>查看 。此外这家服务商偶尔还会发送一些促销邮件，有一些价格很低的套餐值得一试。</p>
<h3 id="3-选购服务器">3. 选购服务器</h3>
<p>再次点击右上角的加号，选择 Cloud Server ，进入配置选择界面，如下图。</p>
<figure data-type="image" tabindex="8"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220222241.png" alt="" loading="lazy"></figure>
<p>新用户有首月 $1.99 的优惠，我这里已经变回正常价格了。</p>
<p>可供选择的镜像类型如下图</p>
<figure data-type="image" tabindex="9"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/20181220222459.png" alt="" loading="lazy"></figure>
<p><em>这里说明一点， 列表最下放的 CentOS 7.5 是开启了BBR加速的，访问速度可能会好一点。当然，也可以选择默认不开启BBR的服务器，然后自己手动启动BBR加速，也不会很麻烦。</em></p>
<p>根据自己的需要选择配置，如果只是用来搭梯子的话，统统选择最低配置就完全够用了。 再有一点，hostname项，如果有自己的域名的话可以填写，也可以随便起个名字（Test、Tom、Jerry……）。选择完之后，点击 Deploy Server 生成服务器。</p>
<h3 id="4-查看服务器">4. 查看服务器</h3>
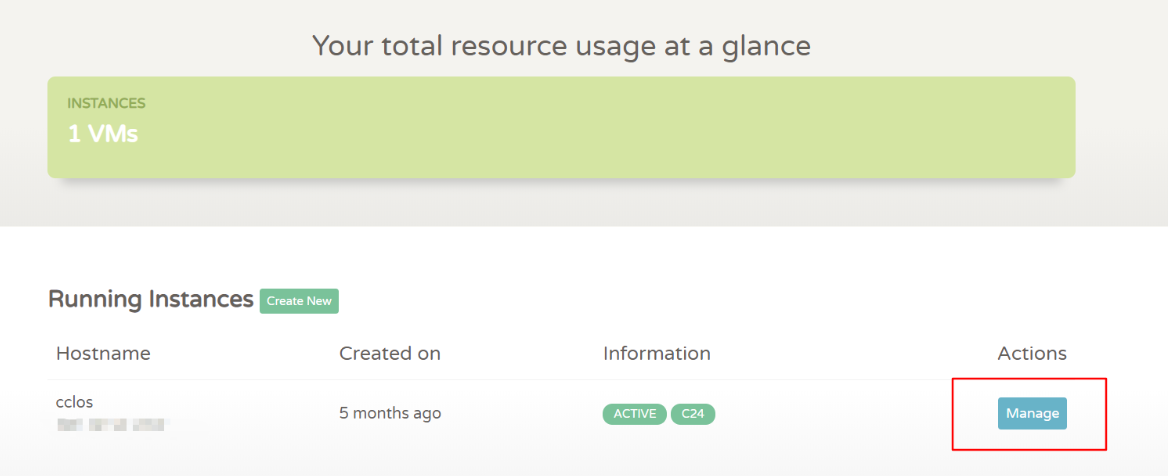
<p>点击最上方导航栏的 Cumpute，就可以看到你刚刚选购完的服务器了，点击 Manage 进入管理页面。</p>
<figure data-type="image" tabindex="10"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/cc20190311173956.png" alt="" loading="lazy"></figure>
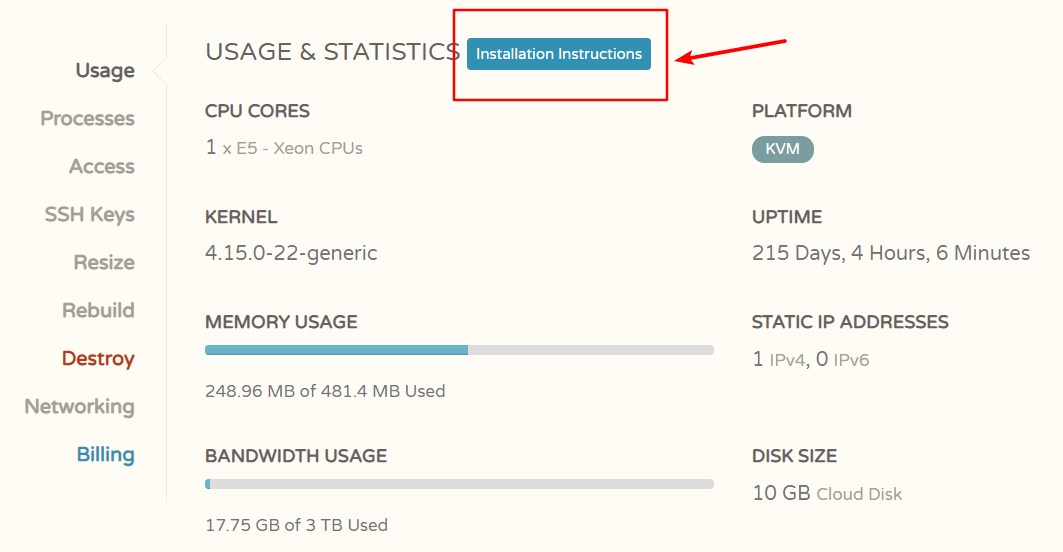
<p>通过管理界面，你可以查看 VPS 实例的资源使用情况，或者进行开关机、重启、连接终端、更换操作系统、销毁vps等一系列操作。</p>
<figure data-type="image" tabindex="11"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/cc20190311170422.png" alt="实例详细信息" loading="lazy"></figure>
<p>如果你想看更详细的资源使用信息（CPU 利用率、内存用量、网速、硬盘用量、平均负载），需要点击上图中的红框，获取安装 stats colelctor 插件的命令，完成安装后即可查看详细资源信息。</p>
<p><em>P.S.  3 TB = 3072 GB，我从来没用完过……</em></p>
<h3 id="5-连接并管理服务器">5. 连接并管理服务器</h3>
<p>推荐使用 Xshell、Mobaxterm、Putty 等 SSH 工具管理你的 VPS。</p>
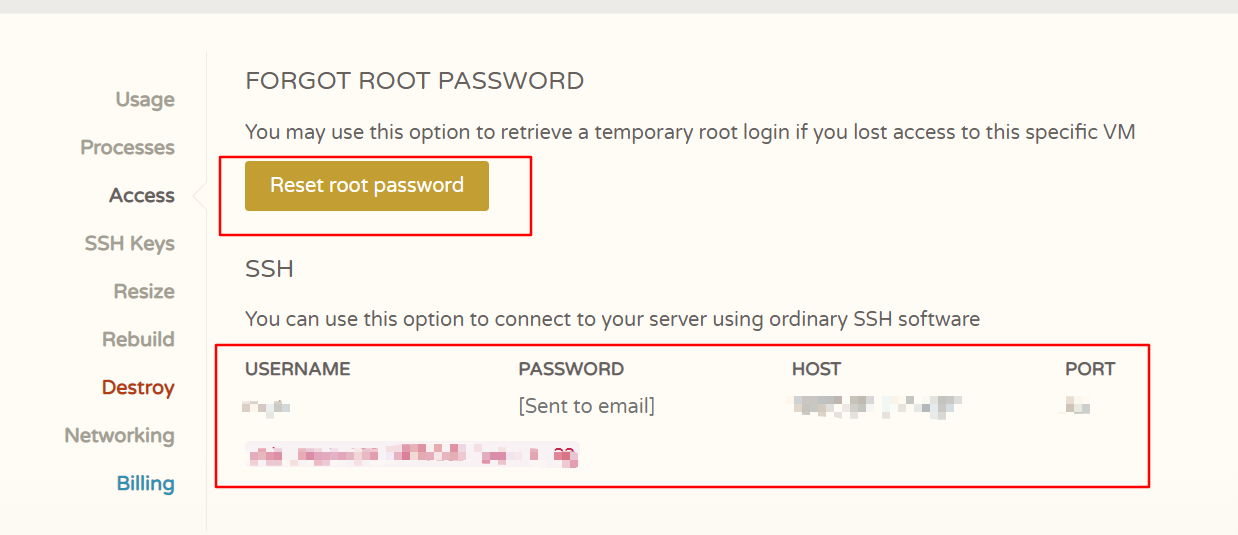
<p>在你完成购买后，CloudCone 会将该实例的 IP 地址、用户名和密码发送到你的注册邮箱，如果你没收到的话，注意查看下垃圾箱。实在不行的话，可以通过 Access → Reset root password 重新获取，如下图。</p>
<figure data-type="image" tabindex="12"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/cc20190311171918.png" alt="重置密码" loading="lazy"></figure>
<p>使用 SSH 连接到服务器，然后部署小飞机之类的，基本配置并不复杂，这里就不展开讲了。（具体步骤可以去看小飞机的文档：<a href="https://github.com/shadowsocks/shadowsocks/wiki/Shadowsocks-%E4%BD%BF%E7%94%A8%E8%AF%B4%E6%98%8E">地址</a>）</p>
<h3 id="6-科学上网测试">6. 科学上网测试</h3>
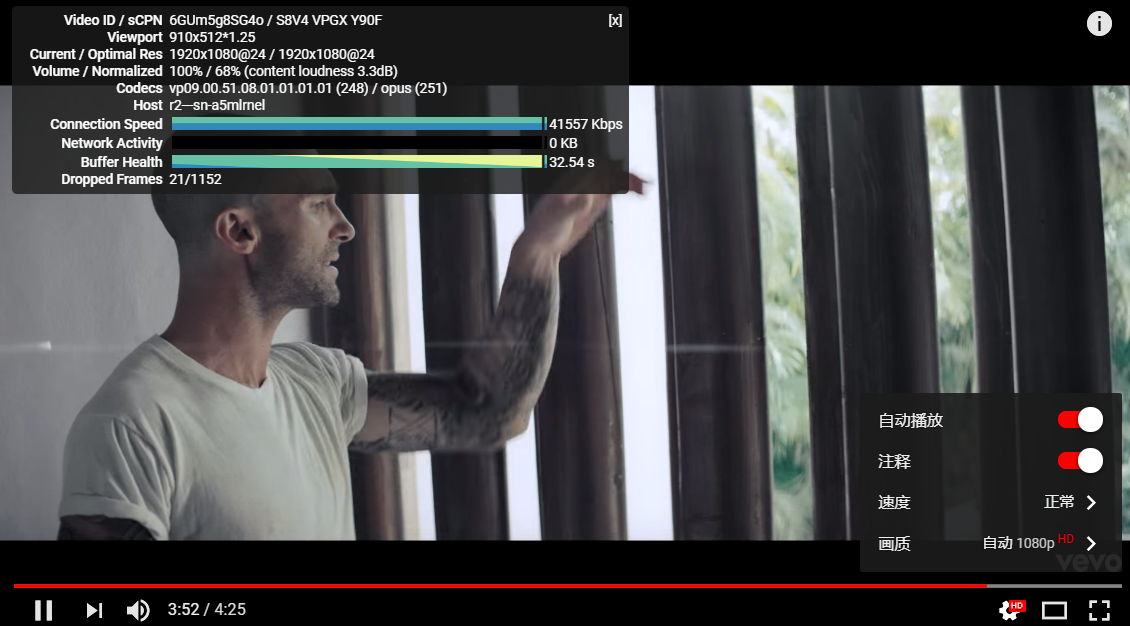
<p>测试环境：200M带宽<br>
效果如下图，有兴趣的朋友可以上手试试。</p>
<figure data-type="image" tabindex="13"><img src="https://raw.githubusercontent.com/Littlecowherd/Images/master/markdown/cc20190311172855.png" alt="Youtobe" loading="lazy"></figure>
]]></content>
    </entry>
</feed>